Weniger Bias, besserer Transfer?
Eine KI für alles Mögliche, trainiert nur auf Alltagsfotos, hat nie ein medizinisches Bild gesehen — und liest trotzdem ein Hirn-CT erstaunlich gut. Die eigentliche Frage ist also: Was macht das möglich? Die Antwort war nicht das, worauf ich gewettet hatte.
Eine illustrative Demonstration auf öffentlichen, unvollkommenen Daten (RSNA-ICH 2019). Sie zeigt, was die Methode kann — sie ist kein klinisches Produkt und erhebt keinen klinischen oder regulatorischen (MDR) Anspruch.
Zuerst die Grundlagen: wie diese KIs sehen lernen
Alles Weitere ruht auf drei Ideen: wie ein Modell ohne Etiketten lernt, wie viel menschliche Annahme jeder Lernstil einbaut (sein Inductive Bias) und der Testaufbau mit eingefrorenem Encoder. Die Drei-Minuten-Fassung — als Video oder hier zum Lesen.
Zum Ausklappen: der Testaufbau, die CT-Fenster und die drei Lernstile
Der Test in einfachen Worten: der Künstler und die Medizinstudentin
Man stelle sich die KI als Künstler mit einem außergewöhnlichen Auge vor, der Millionen Bilder studiert hat — Katzen, Autos, Landschaften. Wir bitten ihn nicht um eine Diagnose. Wir geben ihm einen Hirnscan und eine einzige Anweisung: „Schreib in deiner eigenen Kurzschrift auf, was dir auffällt — jede Kante, Textur, jeden hellen Fleck, jede Asymmetrie." Er weiß nicht, was eine Blutung ist; er beschreibt nur, was da ist, jedes Mal auf dieselbe sorgfältige Weise. Diese Notizen sind seine Lesart des Scans.
Dann kommt eine Medizinstudentin im ersten Jahr dazu, die den Scan nie sieht — sie liest nur die Notizen des Künstlers. Aus einem Stapel alter Fälle (die Notizen plus die bekannte Antwort) lernt sie, welche Kritzeleien typischerweise mit „Blutung" einhergehen. Das ist das Einzige, was wir trainieren, und es dauert Minuten. Der eigentliche Test lautet also: Wie gut sind die Notizen des Künstlers? Und weil wir den Künstler nie umlernen (er bleibt eingefroren), ist der Vergleich zwischen den Künstlern fair, und die Studentin braucht nur eine Handvoll Beispiele.
| Zutat | Wahl |
|---|---|
| Daten | RSNA Hirn-CT (2019, öffentlich) — ~752.000 Schnitte, 21.744 Patienten |
| Verwendete Schnitte | ~187.000 — etwa ein Viertel des Datensatzes (eine Stichprobe, nicht der ganze Satz) |
| Frage | Liegt eine Hirnblutung vor? — plus der Wettbewerbs-Score über sechs Kategorien |
| Vorverarbeitung | 3 klinische „Helligkeitsfenster" (Hirn / subdural / Knochen), jedes als eigenes Graustufenbild |
| Die KI-Modelle | Eingefroren — DINOv2, DINOv3, I-JEPA, ResNet, ConvNeXt — plus zwei „Außenseiter": ein Vision-Language-Modell (Qwen) und ein Dokument-Encoder (Donut) |
| Was wir trainieren | Eine logistische Regression pro Fenster auf den eingefrorenen „Notizen" — dann die drei gemittelt |
| Fairness | Getrennt nach Patienten (kein Leakage), fester Zufalls-Seed |
Was ein „Fenster" wirklich ist — selbst ausprobieren
Ein CT speichert keine Helligkeit, sondern Dichte in Hounsfield-Einheiten (HU), von Luft (−1000) bis dichtem Knochen (+2000 und mehr). Ein Bildschirm kann nicht 4.000 Abstufungen auf einmal zeigen, also wählt man ein Fenster — einen Ausschnitt der HU-Skala, gedehnt auf vollen Schwarz-Weiß-Kontrast. Der Haken: graue Substanz, weiße Substanz und frisches Blut — die ganze Frage in einem Kopf-CT — liegen in einem nur ~70 HU schmalen Streifen dieser 4.000-HU-Skala. Verschieb das Fenster unten und beobachte, was auftaucht und verschwindet:
Schematic phantom, not a patient scan (the dataset licence forbids patient images). The brightness of every region is the real windowing transform — screen value = (HU − window-low) / width — applied to real tissue densities. The window (orange band on the scale) is the sliver of the 4,000-HU range stretched to full black-to-white; everything below it turns black, everything above turns white. Picking where to place it is a human choice — which is exactly why the article asks whether a few standard windows read all the signal.
Drei Arten, einer KI das Sehen beizubringen (plus ein Außenseiter)
Jeder Lernstil hinterlässt einen anderen Fingerabdruck menschlicher Annahmen im Modell — wie viel jemand vorab festgelegt hat, was zählt. Dieser Fingerabdruck, der Inductive Bias, ist die Achse, um die sich das ganze Experiment dreht.
1 · Supervised (denk „ResNet"): Zeig dem Netz Millionen Bilder, jedes von einem Menschen mit einer von 1000 Kategorien beschriftet, und trainiere es, die Kategorie zu erraten. Menschlicher Fingerabdruck: schwer — die Liste der Kategorien entscheidet, was das Modell für „wichtig" hält. Ein Katze-gegen-Hund-Detektor lernt, was Katzen von Hunden trennt — nicht, wie eine Hirnblutung aussieht.
2 · Self-Distillation (die „DINO"-Familie — DINOv2, DINOv3): keine Etiketten. Zeig dem Modell zwei verzerrte Varianten desselben Bildes — anders zugeschnitten, in der Farbe verschoben — und trainiere es, für beide dieselbe innere Beschreibung zu erzeugen. Menschlicher Fingerabdruck: mittel — die Annahmen stecken in den Verzerrungen. „Farbe ist egal" ist eine gute Regel für Fotos, aber im CT ist die Helligkeit das medizinische Signal. Dieses eingebaute „Farbe ist egal" nennen wir später den Farb-Bias.
3 · I-JEPA — der vorhersagebasierte Stil. Keine Etiketten, keine Farb-Tricks. Es verdeckt einen Teil des Bildes und lässt das Modell die innere Beschreibung des verdeckten Teils aus dem Sichtbaren vorhersagen — im „Kopf", nicht als Pixel. Menschlicher Fingerabdruck: leicht. Weil es am wenigsten einbaut, ist es der natürliche Kandidat für die Wette, auf die wir am Ende kommen.
4 · Language-Supervised (ein multimodales Modell wie Qwen): ein großes Sprachmodell mit angebautem Vision-Encoder, trainiert auf Bild-Text-Paaren, bis es zwischen Bild und beschreibenden Worten wechseln kann. Menschlicher Fingerabdruck: schwer — aber aus Sprache. Fachfremd für rohe CT-Textur, trägt aber etwas, das keiner der anderen hat: es verbindet Bilder mit Text. Für die Bias-Frage kein direkter Gegner — es taucht in Kapitel 2 als bewusster Außenseiter auf.
| Stil | Braucht Menschen-Annotationen? | Lernt durch… | Eingebaute Annahmen |
|---|---|---|---|
| Supervised (ResNet) | Ja | Vorhersage des Annotationen | Schwer |
| DINO (Self-Distillation) | Nein | Abgleich verzerrter Ansichten | Mittel |
| I-JEPA (vorhersagebasiert) | Nein | Vorhersage verdeckter Bedeutung | Leicht |
| Language-Supervised (VLM) | Nein (nutzt Captions) | Abgleich Bild zu Wort | Schwer — sprachlich |
Eine Anmerkung für technisch Neugierige: I-JEPA ist eine Joint-Embedding Predictive Architecture — nicht autoregressiv und ohne Pixel-Rekonstruktion; es sagt Repräsentationen verdeckter Regionen voraus. DINO ist eine Invarianz- bzw. Self-Distillation-Methode, keine generative.
Also — mit eingefrorenem Künstler und in Minuten trainierter Studentin: funktioniert es überhaupt?
Eine KI, die nur Alltagsfotos kennt, erkennt Hirnblutungen — eingefroren, ohne jedes medizinische Training.
Die großen Modelle einfrieren, jedes den CT-Schnitt 'lesen' lassen und nur einen winzigen Klassifikator auf den Notizen trainieren. Selbst so erreichen die besten selbstüberwachten Modelle rund 0,94 AUC bei 'Blutung ja/nein' — ein glaubwürdiger Startpunkt für medizinische Bildgebung in Stunden, nicht Monaten.
≈0,94 AUC eingefroren · winziger Klassifikator in Minuten trainiert · getrennt nach Patienten, fester SeedIn der Tiefe: das Ergebnis, und wie wenig dafür nötig ist
Es funktioniert, und das ist der überraschende Teil. Mit dem Aufbau aus den Grundlagen — ein eingefrorener Encoder plus ein winziger Klassifikator pro Fenster — erreichen die besten Modelle ab Werk rund 0,94 AUC bei der schlichten Frage „liegt eine Blutung vor?". Kein Fine-Tuning, kein medizinisches Vortraining; das große Modell lernt nicht einmal, was eine Blutung ist. Es beschreibt nur den Schnitt, und eine logistische Regression auf diesen Beschreibungen erledigt den Rest.
Bemerkenswert ist, wie wenig dafür nötig ist. Die großen Modelle bleiben eingefroren, es gibt also kein teures Umtrainieren; nur der kleine Klassifikator lernt, in Minuten. Eine brauchbare Ausgangsbasis steht in Stunden, nicht Monaten. Die naheliegende nächste Frage — und der Rest dieses Artikels — ist, was diesen Wert eigentlich antreibt.
Es funktioniert — aber was macht es aus? Drei Hebel, der größte zuerst.
Was ein Modell gelernt hat, schlägt das Wie: ein satellitentrainierter Zwilling liest Hirn-CT besser als sein web-trainiertes Double.
Der größte Hebel ist nicht das Trainingsrezept — es ist die Welt, aus der das Modell gelernt hat. Ein dokument-trainierter Encoder scheitert am Hirn-CT; ein breit trainiertes Vision-Language-Modell kommt fast an die Foto-Modelle heran; und — der sauberste Schnitt — dieselbe DINOv3-Architektur, auf Satellitenbildern vortrainiert, schlägt ihren Web-Foto-Zwilling um +0,013 AUC, über jeden Datensatz-Ausschnitt, den wir probiert haben.
DINOv3 ViT-L, eingefroren, native Auflösung: Web 0,930 vs. Satellit 0,943In der Tiefe: die Außenseiter, der saubere Zwillingstest und die Größen-'Skyline'
Wenn es auf die Notizen ankommt, dann sollte zählen, was der Künstler vorher studiert hat — mehr als der genaue Stil, in dem er studiert hat. Um das zu prüfen, zwei bewusste Außenseiter, Encoder für etwas ganz anderes, auf einem Ausschnitt von 40.000 Schnitten: Qwen, ein Vision-Language-Modell, und Donut, ein Encoder zum Lesen gescannter Dokumente.
| Modell | Vortrainiert auf | AUC (40k-Ausschnitt, eingefroren) |
|---|---|---|
| DINOv2-giant | Alltagsfotos (selbstüberwacht) | 0,926 |
| Qwen (Vision-Language) | Webbilder und ihre Captions | 0,916 |
| Donut | gescannte Dokumente | 0,806 |
Der Dokumentleser ist klar der schwächste — seine Welt (Text auf Papier) liegt einfach zu weit vom CT weg. Bemerkenswerter: das Vision-Language-Modell kommt bis auf ~0,010 an das beste foto-trainierte Modell heran, obwohl es nie als reines Bildmodell gebaut wurde.
Qwen und Donut unterscheiden sich auch in Größe und Architektur, es ist also kein sauberer Schnitt. DINOv3 erlaubt den sauberen: dieselbe Architektur, dieselbe Größe, auf zwei verschiedenen Welten vortrainiert. Die Satelliten-Version gewinnt um +0,013 — und das über jeden Ausschnitt. Warum sollte ein Modell, das die Erde aus dem Orbit studiert hat, einen Hirnscan besser lesen als eines, das Katzen und Autos studiert hat? Eine plausible Lesart, eine Hypothese: Satellitenbilder liegen näher an einem CT-Schnitt als ein Foto — weitgehend Graustufen, textur- und kantendominiert, flache Querschnitte, keine Farb-und-Objekt-Semantik von Alltagsfotos.
Größer lohnt sich nicht immer (bei diesem Budget)
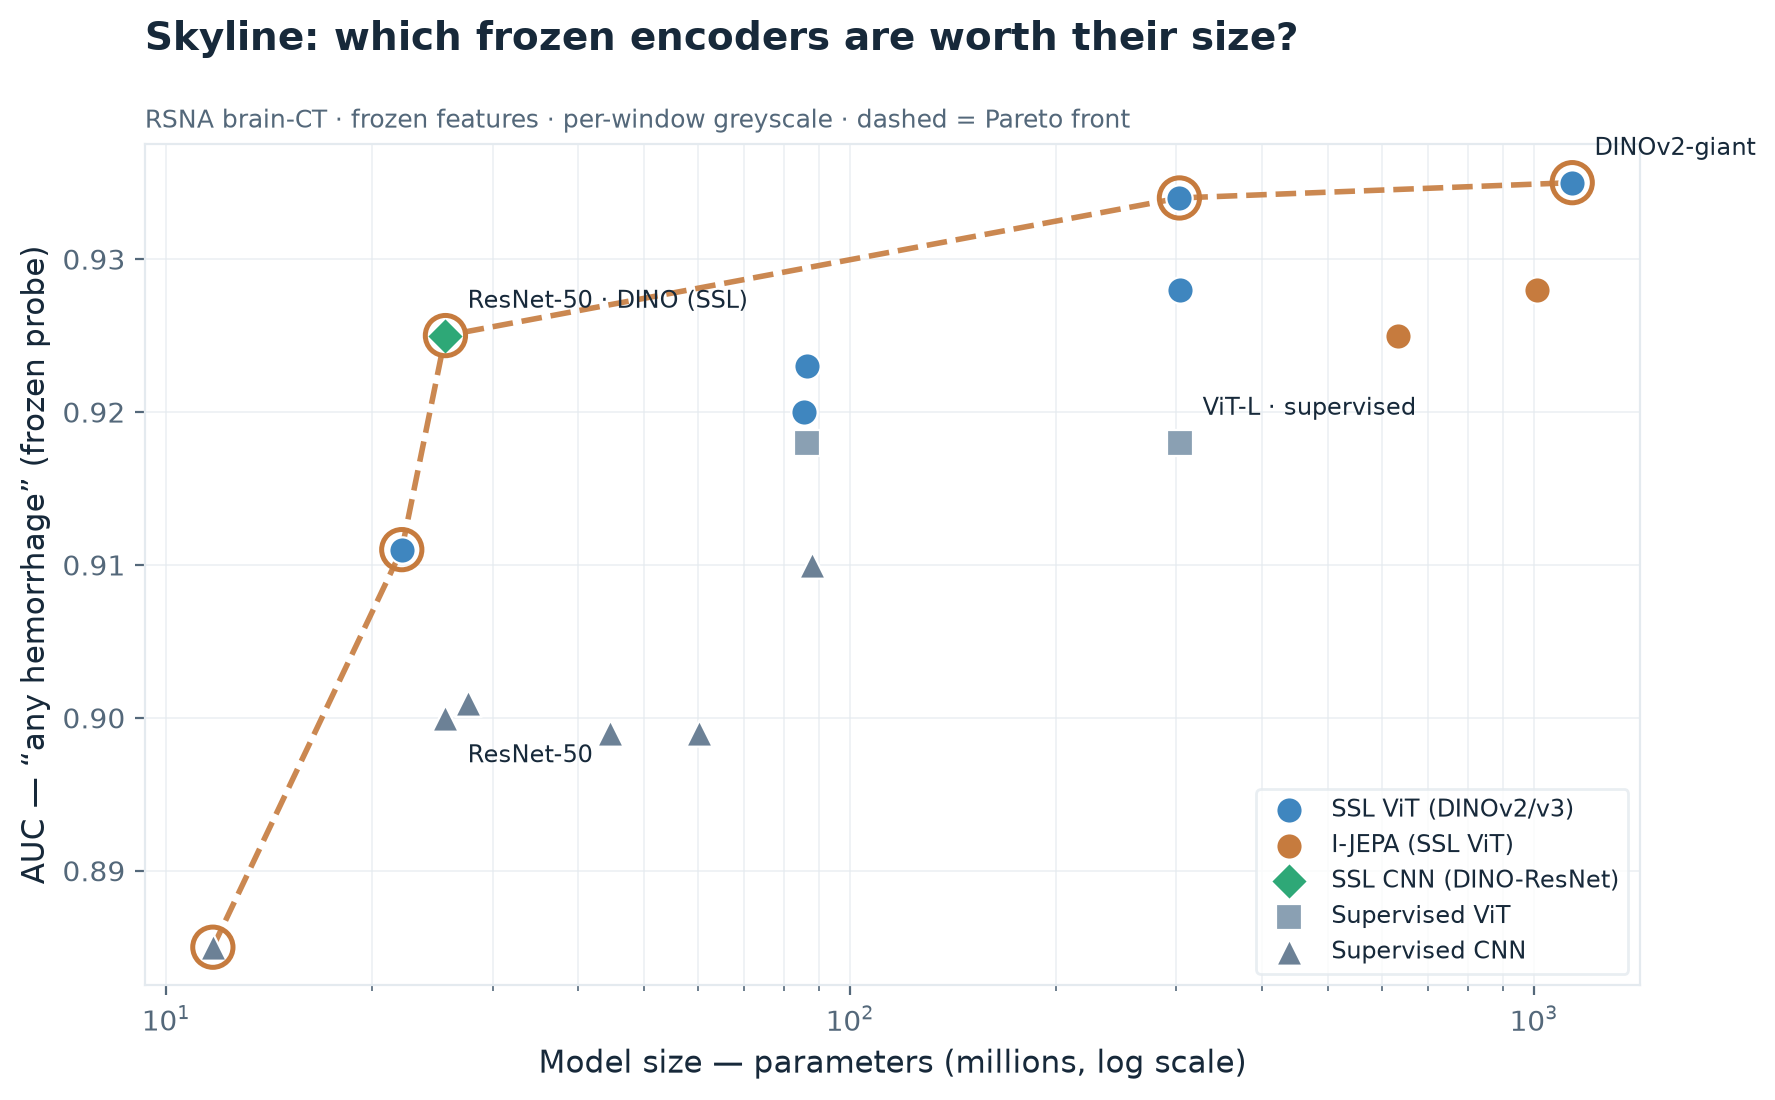
Ein Vorbehalt: Diese Skyline ist eine Momentaufnahme bei festem Rechenbudget, keine Aussage über Skalierung. Wir trainieren nur eine kleine Probe auf eingefrorenen Features, also überanpassen die höherdimensionalen Notizen eines größeren Modells diese Probe stärker — umso mehr, je weniger Daten man nutzt. Der allergrößte Encoder (7B Parameter) lief aus Budgetgründen nur auf einem kleinen Teil der Schnitte. Lies die Position der großen Modelle als unser Budget, nicht als ihre Obergrenze.
Verschiedene Lernstile sehen Verschiedenes — deshalb schlägt eine gezielt gewählte Handvoll das Zusammenwerfen aller.
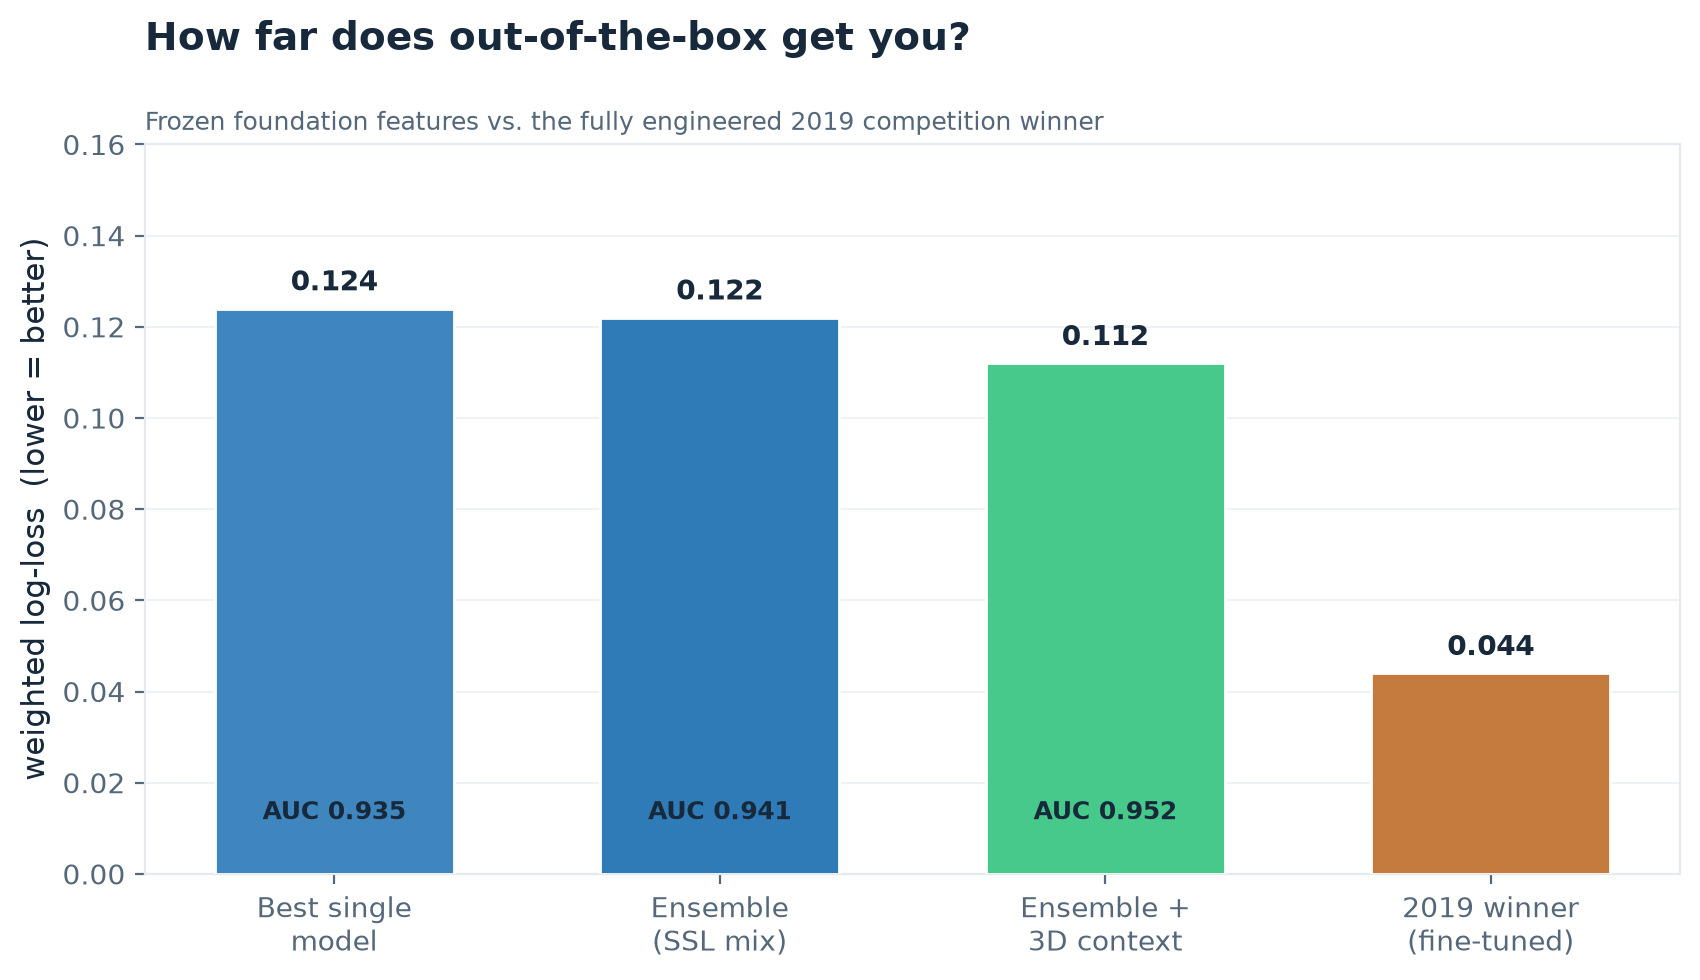
Kein einzelnes Modell gewinnt allein, und keines ist überflüssig: verschiedene Modelle machen wirklich verschiedene Fehler, also fängt ein kleines, kuratiertes Ensemble Signal ein, das keines allein sieht: 0,935 (bestes Einzelmodell) → 0,941 (sechs Modelle) → 0,952 (plus 3D-Kontext) → 0,955 (gezielte Auswahl über Modelle, Fenster und Kontext).
0,935 → 0,955 AUC — jeder Gewinn auf Validierung gewählt, einmal auf Held-out-Test gemessenIn der Tiefe: das Ensemble, wählen statt zusammenkippen, und wo das vorhersagebasierte Modell punktet
Alles zusammenzuwerfen ist der falsche Reflex. Das beste Ensemble ist eine kuratierte, vielfältige Handvoll von sechs — alle ~20 Modelle hineinzuwerfen ist leicht schlechter (0,934): die schwächeren Supervised-CNNs verwässern nur den gleichgewichteten Mittelwert. Dasselbe gilt eine Ebene höher: alle ~240 Kandidaten zusammenzuwerfen (jedes Modell, beide Auflösungen, jedes Fenster, mit und ohne Nachbar-Kontext) landet bei 0,946 — nicht besser als die Handvoll. Was funktioniert, ist zu wählen: eine greedy Auswahl, auf einem Validierungs-Split zusammengestellt und einmal auf einem unberührten Test-Split gemessen, erreicht 0,955 AUC (+0,009 gegenüber dem Zusammenwerfen, 95%-KI klar über null). Sie behält 63 von ~240 Kandidaten und entdeckt jeden Hebel dieses Artikels auf einmal wieder.
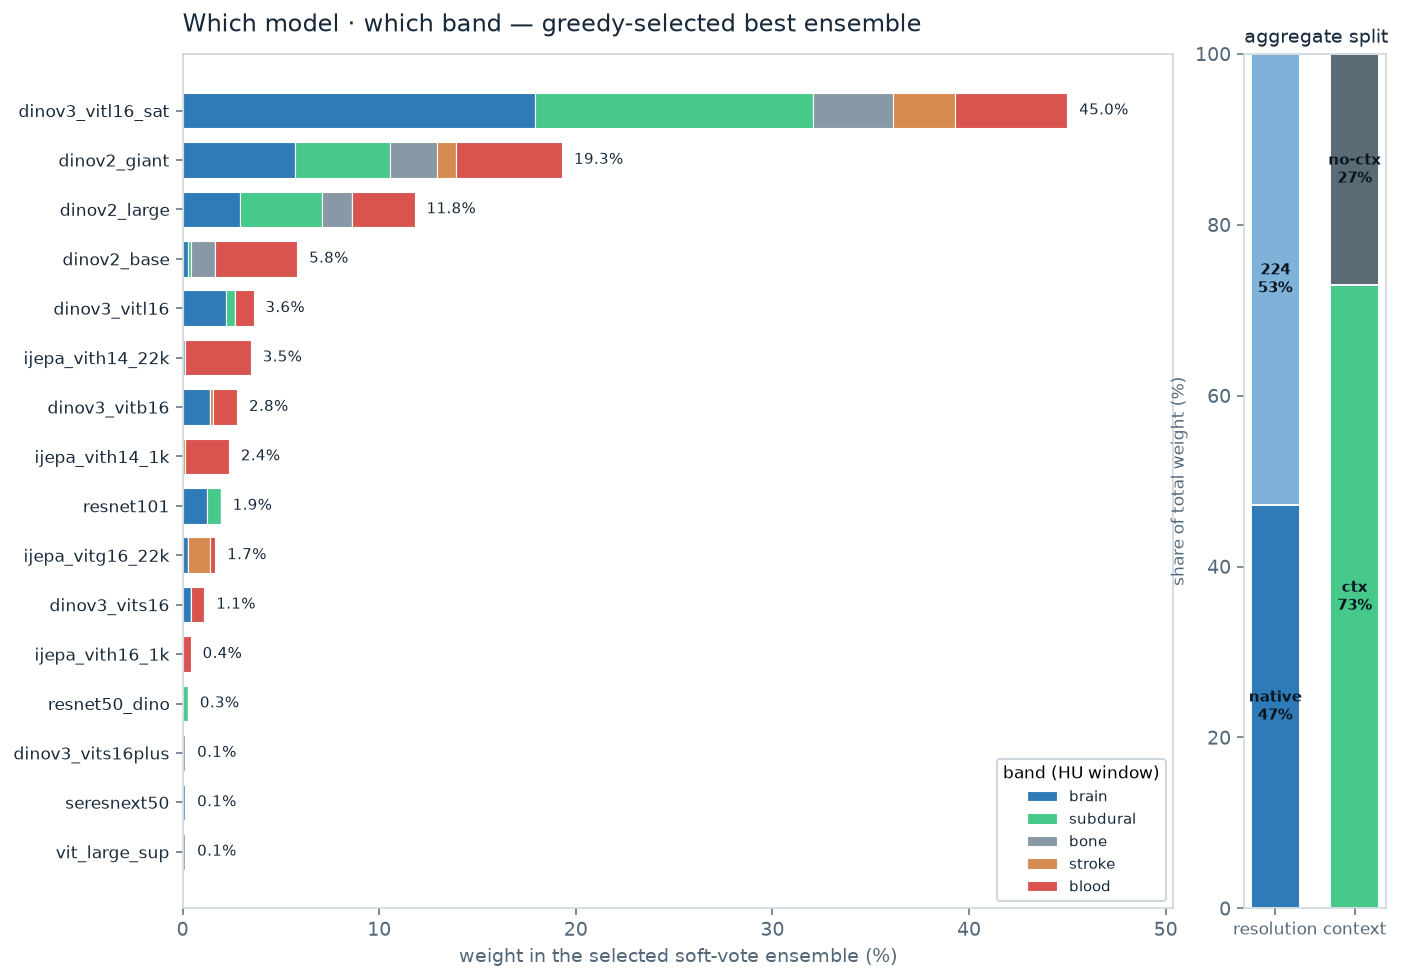
Zwei weitere Hebel brauchten gar kein Nachtrainieren. Zwei schmale Fenster hinzuzufügen — eines auf dem feinen Grau-Weiß-Band, eines auf dem Frischblut-Band — bringt einen kleinen, aber statistisch bedeutsamen Zuwachs (+0,004 Held-out). 3D-Kontext — jeder Schnitt borgt sich die gemittelten Notizen seiner Nachbarn, da eine Blutung meist über mehrere benachbarte Schnitte reicht — bringt deutlich mehr (+0,012, ebenfalls signifikant).
Und etwas fast Poetisches fällt aus der Zerlegung. Sortiert man das Gewicht jedes Modells nach Fenster, spaltet sich das Ensemble entlang der Inductive-Bias-Achse aus den Grundlagen. Die Supervised-CNNs tragen nur über die breiten klinischen Fenster bei (0% aus den schmalen). Das bias-arme I-JEPA ist das Spiegelbild: ~95% seines Beitrags fließen durch die schmalen Blut- und Schlaganfall-Fenster (79% allein aus Blut). DINO liegt dazwischen. In einem Satz: je leichter die eingebauten Annahmen eines Modells, desto mehr liegt sein einzigartiger Wert in der scharfen, lokalen „ist hier ein heller Fleck?"-Sicht. Merk dir das — es ist der erste Hinweis, dass „bias-arm" etwas Spezifisches bringt, auch wenn es nicht allein gewinnt.
I-JEPA lernt, den verdeckten Teil eines Bildes aus seiner Umgebung vorherzusagen — „was gehört hierher, gegeben der Kontext?" — und trainiert ohne Farb- oder Kontrast-Tricks. Es sollte also ungewöhnlich wach für eine Region sein, die von dem abweicht, was ihre Nachbarschaft vorhersagt, und es behält den rohen Kontrast, statt ihn wegzulernen. Das schmale Blutfenster ist genau diese Situation: alles flach abgeschnitten, außer einem hellen Fleck frischen Bluts, der aus einem gleichmäßigen Feld heraussticht. DINOs Stärke — Invarianz gegen Aussehen, Zuschnitt und Farbe — passt dagegen zu den breiten, texturreichen Fenstern. Wenn das hält, hieß „weniger Inductive Bias" nie „besser" — es hieß komplementär. Das Naheliegende, das man als Nächstes testen sollte.
Methodik-Notiz. Jeder Gewinn hier wird auf Validierung gewählt und einmal auf einem Held-out-Test berichtet, mit patientenweisen Bootstrap-Konfidenzintervallen. Das sind Out-of-Sample-Gewinne, keine auf dem Testset getunten Zahlen — und diese Disziplin zu benennen ist der Punkt: sie macht kleine, echte Unterschiede vertrauenswürdig.
Rund 50 annotierte Scans schlagen bereits den Zufall — das Regime seltener Befunde ist machbar.
Der dritte Hebel ist, wie wenig man braucht. In der Medizin ist die drängende Frage oft das Gegenteil von Big Data: für einen seltenen Befund hat man vielleicht nur eine Handvoll annotierter Fälle. Mit eingefrorenen Features landen ~50 Beispiele bei ~0,74 AUC, ein paar hundert erreichen ~0,84, und die Kurve flacht nach einigen Zehntausend ab.
50 Annotationen → 0,74 · 500 → 0,84 · 1.000 → 0,86 · 133.000 → 0,935In der Tiefe: die Few-Shot-Kurve und ihr Vorbehalt
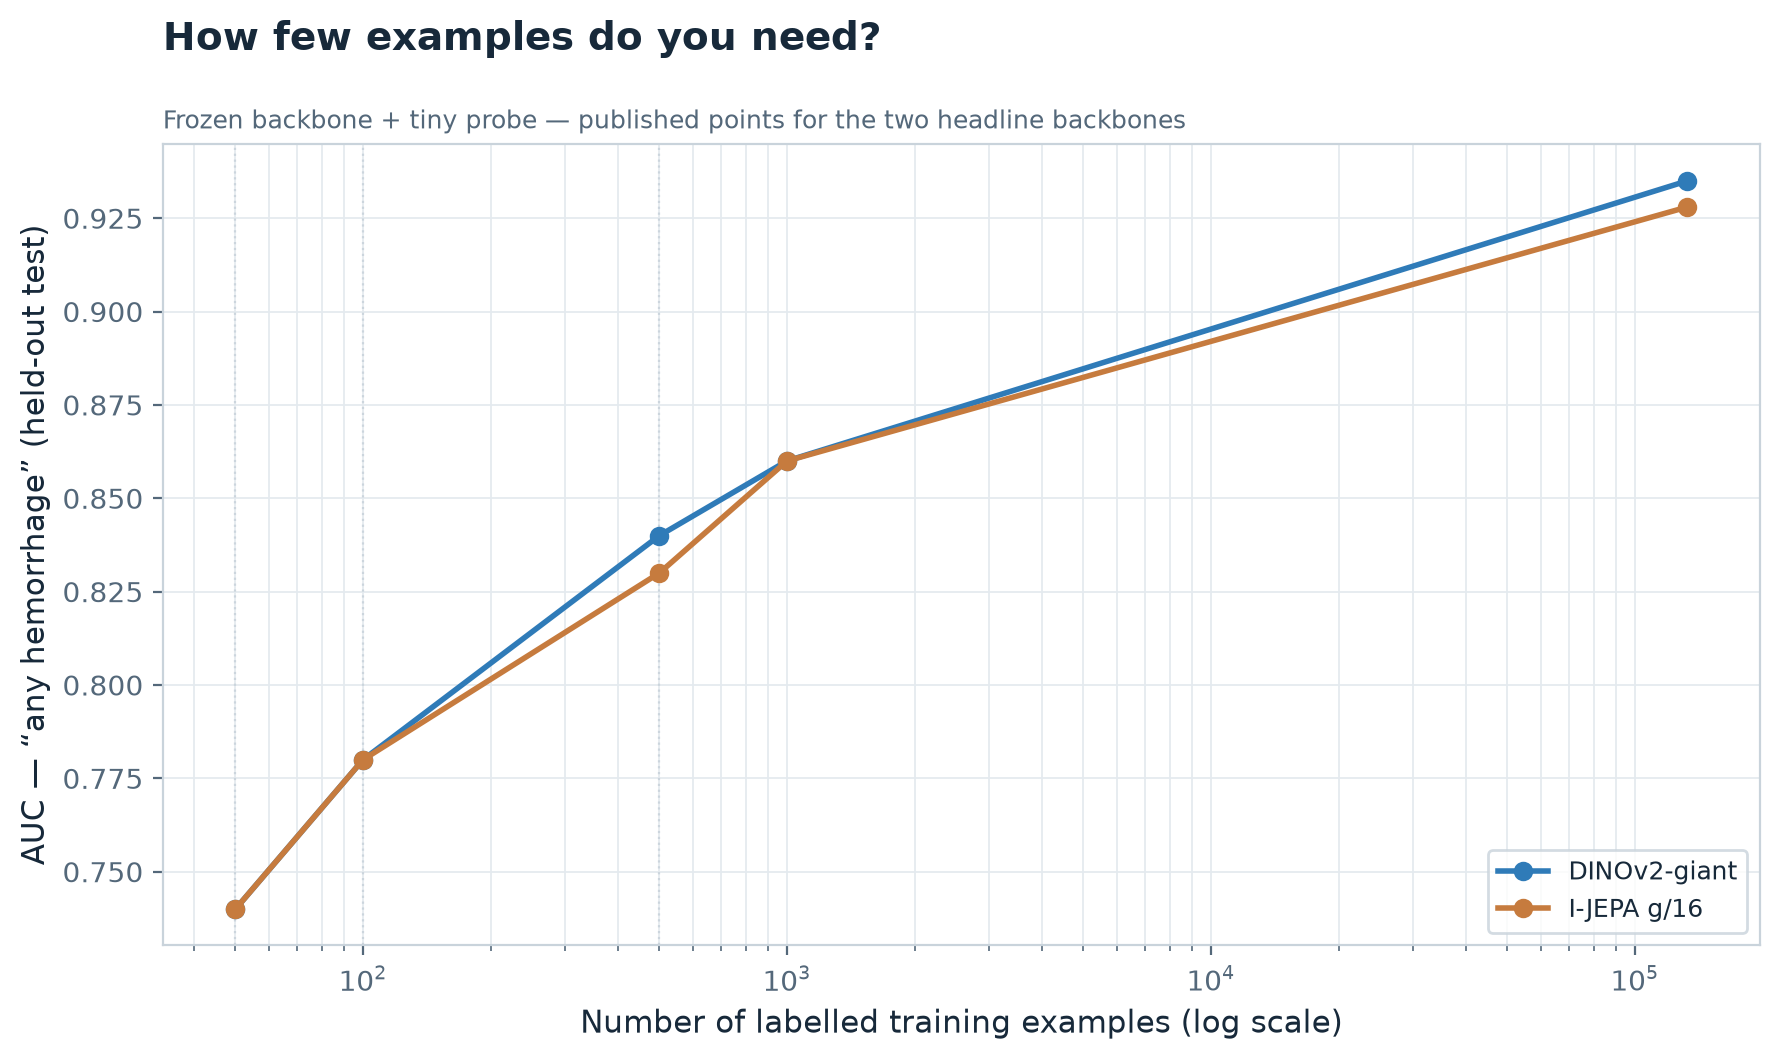
Deshalb unterscheidet sich unser Viertel des Datensatzes kaum von der Nutzung aller Daten — und deshalb ist ein brandneuer Befund mit nur ein paar hundert Annotationen mit eingefrorenen Features nicht hoffnungslos.
Wie weit das trägt, hängt davon ab, wie auffällig der Befund ist. Eine Hirnblutung ist relativ sichtbar; ein subtiler Befund bräuchte mehr Beispiele. Der Weg ist immer, es an den eigenen wenigen Beispielen zu testen — genau wie hier.
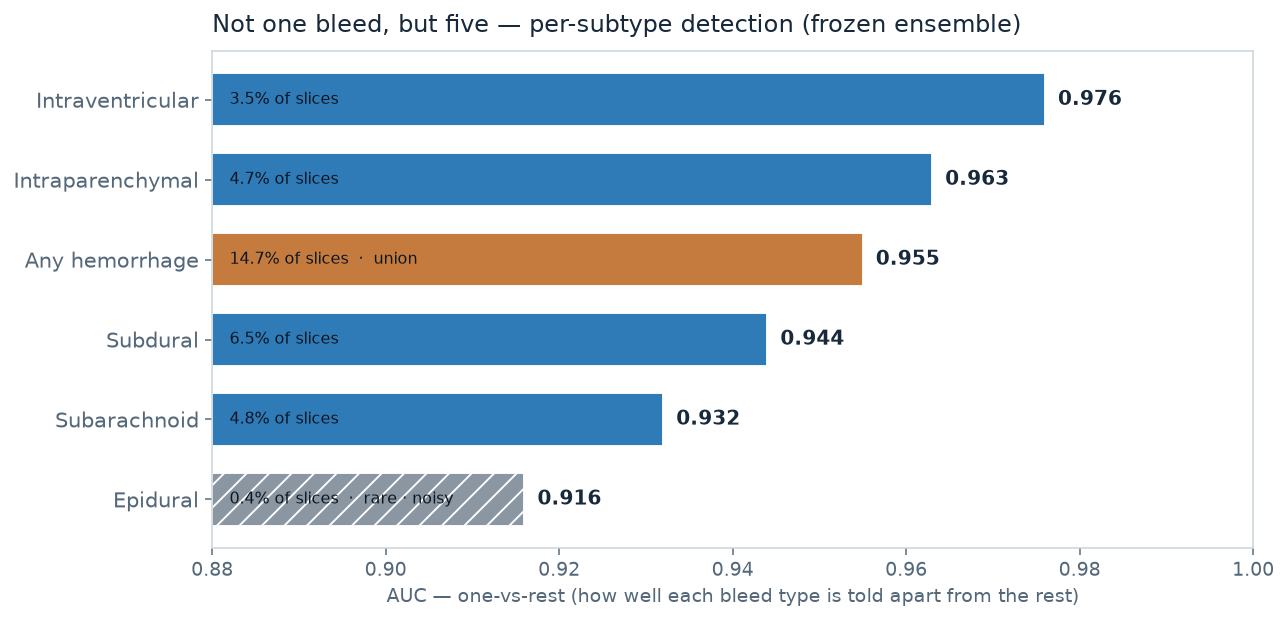
Nicht eine Blutung, sondern fünf — unterschieden bei 0,92–0,98 AUC, und der Typ entscheidet, was als Nächstes passiert.
Dieselben eingefrorenen Notizen tragen mehr als 'Blutung ja/nein'. Jeder Schnitt ist für fünf Blutungstypen annotiert, mehrere können gemeinsam auftreten, also ist es ein Multi-Annotation-Problem: ein winziger Klassifikator pro Typ. Die Reihenfolge ist klinisch sinnvoll — dichte, gut lokalisierte Blutungen sind am leichtesten; die dünne, diffuse Subarachnoidalblutung ist der schwerste häufige Typ.
Intraventrikulär 0,976 · intraparenchymal 0,963 · subdural 0,944 · subarachnoidal 0,932 · epidural 0,916 (selten, verrauscht)In der Tiefe: Ergebnisse pro Typ, Behandlungspfade und der Abstand zum 2019er-Gewinner
Warum der Typ zählt — nicht nur, dass Blut da ist
Die fünf Typen verzweigen sich in verschiedene Behandlungspfade: ein anderer Arzt anzurufen, eine andere Untersuchung als Nächstes, ein anderer Raum vorzubereiten.
| Typ | Was er typischerweise auslöst |
|---|---|
| Epidural | arteriell, kann schnell entgleisen → neurochirurgische Ausräumung (OP) |
| Akut subdural | Raumforderung → neurochirurgische Ausräumung (OP) |
| Subarachnoidal | meist aneurysmatisch → CT-Angiografie, dann Coiling / Clipping; oft eine Verlegung |
| Intraventrikulär | Hydrozephalus-Risiko → Ventrikeldrainage |
| Intraparenchymal | Blutdruckkontrolle, Aufhebung der Antikoagulation, Intensivmedizin |
Der Typ, nicht nur das Vorhandensein von Blut, entscheidet also, was als Nächstes passiert — ihn innerhalb von Sekunden nach dem Scan zu kennen, lässt den richtigen Pfad früh statt erst nach der Befundung beginnen.
Der Realitätscheck: wie weit von den Experten?
Der Wettbewerb 2019 wurde mit einem schwer engineerten System gewonnen: drei feinabgestimmte CNN-Architekturen, über Kreuzvalidierungs-Folds gemischt, zwei Sequenzmodelle, die Kontext über Schnitte lesen, plus Test-Time-Augmentation. Unser schneller, eingefrorener Ansatz landet bei rund dem 2,6-Fachen des Fehlers des Gewinners — weit von der Spitze, erreicht mit einem Bruchteil des Aufwands. Dieser Abstand ist im Log-Loss; beim reinen Ranking (sortiert es Blutungen über Nicht-Blutungen?) ist unser Ensemble bereits stark (~0,95 AUC). Der Rückstand ist vor allem Fähigkeit (Fine-Tuning), nicht Kalibrierung: die Konfidenz im Nachhinein anzupassen verschiebt den Wert nur um ~0,001.
Eine Erwartung aber hielt den Daten nicht stand — die Wette, die wir in den Grundlagen aufgestellt haben.
Die Wette — „weniger Bias heißt besserer Transfer“ — ging nicht auf: DINO bleibt vor I-JEPA.
Erinnern wir uns an die naheliegende Erwartung: weil I-JEPA am wenigsten menschliche Annahme einbaut, sollte es sich am besten an eine nie gesehene Domäne anpassen. Vernünftig, durch die Literatur gestützt — und nicht das, was geschah. Die besten drei eingefrorenen Modelle sind alle DINO; I-JEPA liegt knapp dahinter.
DINOv2-giant 0,935 · I-JEPA g/16 0,928 — die starke Form der Hypothese fälltIn der Tiefe: die Tabelle, warum der Farb-Bias nicht griff, und der eine saubere Sieg
Wir haben gerade gesehen, wie I-JEPA im Ensemble seinen Beitrag leistet, besonders im schmalen Blutfenster. Aber die Wette aus den Grundlagen war stärker als das: das annahmen-ärmste Modell sollte klar gewinnen. Tat es nicht.
Weil I-JEPA am wenigsten menschliche Annahme einbaut, sollte es sich besser an Domänen anpassen, für die es nie trainiert wurde — etwa medizinische Bildgebung — als die stärker „vorgeformten" Methoden (DINO oder voll überwachte Modelle).
Es ist eine vernünftige Wette, kein Handwedeln. Vorarbeiten deuten in dieselbe Richtung: Farb-Jitter kann gelernte Features aktiv beschädigen (Planckian Jitter, 2022); JEPA-artige Methoden funktionieren ohne schwere Augmentierung (You Don't Need Data Augmentation in SSL, 2024); Invarianz- vs. vorhersagebasierte Methoden passen zu verschiedenen Signalen (Pretext Matters, 2026).
| Modell | Familie | AUC (jede Blutung, eingefroren) |
|---|---|---|
| DINOv2-giant | DINO (Self-Distill.) | 0,935 |
| DINOv3-L/16 (sat) | DINO | 0,934 |
| DINOv2-large | DINO | 0,928 |
| I-JEPA g/16 | I-JEPA (vorhersagebasiert) | 0,928 |
| I-JEPA H/16 | I-JEPA (vorhersagebasiert) | 0,925 |
Das Farb-Argument greift hier kaum. Ein CT ist Graustufen — es gibt keine Farbe, die DINOs Farb-Jitter-Augmentierung fehllernen könnte — also greift die Sorge, seine „Foto"-Annahmen würden bei medizinischen Bildern schaden, weitgehend nicht. Das ist ein Grund, warum die „weniger-Bias-gewinnt"-Wette nicht aufging: es gab kaum Farb-Bias, den man hätte bestrafen können.
Und doch ist I-JEPA nicht geschlagen, sondern gleichauf — es erreicht DINOv2 trotz Training auf einer weit kleineren Bildsammlung, und im Ensemble besitzt es das schmale Blutfenster. „Weniger Bias" hieß also nicht „besser"; es hieß anders und komplementär — am ehesten zahlt es sich in Daten-Effizienz aus, nicht im rohen Transfer.
Ein sauberer, kontrollierter Sieg für Self-Supervision
Die Wette auf den Bias fiel, aber ein einfacherer Vergleich hielt. Hält man alles konstant außer dem Lernstil — dasselbe ResNet-50, dieselben Daten, nur supervised vs. selbstüberwacht — gewinnt Self-Supervision klar: 0,900 vs. 0,925 AUC (+0,025). Für die neueren Transformer-Modelle war der Unterschied klein und mit anderen Faktoren verwoben — ein Indiz, kein Beweis.
Wo zahlt sich das alles also aus?
Was es bedeutet: eine Klinik könnte ihre eigene Triage für die Befunde bauen, die kein Anbieter abdeckt — aus einer Handvoll Annotationen.
Für die offensichtlichen, häufigen Befunde ist das ein gelöster, ausgerollter Markt — kommerzielle Werkzeuge triagieren Blutung und großen Gefäßverschluss gut, und wir behaupten nicht, sie zu schlagen. Der interessante Raum ist, was sie nicht abdecken: seltenere Befunde, lokale Patientenmixe, der eigene Workflow jeder Abteilung — wo eingefrorene Features plus ein paar hundert Annotationen genügen, um zu starten, Schritt für Schritt verbesserbar.
Eingefroren starten (Stunden Arbeit) → Annotationen ergänzen → Fine-Tuning → auf eigenen Scans vortrainierenIn der Tiefe: wo es sich lohnt, die Ökonomie, Grenzen und was als Nächstes kommt
| Wenn Sie … sind | Die Kernaussage |
|---|---|
| Neugierig (nicht-technisch) | Eine KI, die nur auf Alltagsfotos trainiert wurde, kann Hirnblutungen schon recht gut erkennen — ohne je „Medizin studiert" zu haben. Das ist die Kraft, den Kern zu lernen. |
| In medizinischer KI | Eingefrorene Foundation-Features sind eine starke, fast kostenlose Baseline — genug, um Workflow-Triage auf eigenen Daten mit einer Handvoll Annotationen zu prototypen und dann in Schritten zu verbessern. Am wertvollsten für die seltenen Befunde, die kein fertiges Werkzeug abdeckt. |
| In der Technik (egal welche Domäne) | Worauf man vortrainiert zählt mehr als das genaue Rezept, und ein vielfältiges Ensemble schlägt ein einzelnes großes Modell. „Weniger Inductive Bias = besserer Transfer" war intuitiv, hielt aber nicht sauber. |
Wo ein günstiger Detektor sich wirklich lohnt
Nicht in einem voll besetzten Stroke-Center um die Mittagszeit. Er lohnt sich, wo Expertise oder Geografie der Engpass ist — und die harten Zahlen hier stammen aus ausgerollten Systemen, nicht von uns:
- Die Verlegungsentscheidung — ein kleines Krankenhaus mit Scanner, aber ohne Neurochirurgie. Die Uhr, die zählt, ist die Door-in-Door-out-Zeit, routinemäßig über zwei Stunden. In einem Hub-and-Spoke-Netz senkte automatische Erkennung sie von 202 → 113 Minuten und die Team-Benachrichtigung von 45 → 7 Minuten (Viz.ai, 2024).
- Das Wochenende, wenn kein Experte im Haus ist. Klinisch relevante Diskrepanzen zwischen vorläufigem und finalem Befund liegen im Bereitschaftsdienst bei ≈2–6%, und die am häufigsten übersehenen Blutungen sind die subtilen — subdural (39%) und subarachnoidal (33%) (AJNR). Das sind genau die zwei Typen, die unser Modell am schwersten findet — aber ein Modell ermüdet nicht um 3 Uhr nachts. Der Wert ist nicht „besser als ein Neuroradiologe"; es ist eine konstante Zweitmeinung, wo keine vor Ort ist.
Warum eine einzelne Klinik das selbst bauen könnte
- Es braucht sehr wenige Annotationen. Die Few-Shot-Kurve erreichte brauchbare Genauigkeit von Zehnern bis wenigen hundert annotierten Fällen — nicht den Zehntausenden, die ein Modell von Grund auf verlangt. Ein klinikeigenes Archiv, vom eigenen Personal leicht annotiert, genügt zum Start.
- Es verbessert sich in Schritten. Beginne mit einem eingefrorenen Modell und einer winzigen Probe — Stunden Arbeit. Wenn ein Befund wichtiger wird, füge Annotationen hinzu; wenn er sehr wichtig ist, mache Fine-Tuning; an der Grenze fahre label-freies Vortraining auf den eigenen unannotierten Scans des Hauses. Jeder Schritt ist optional und baut aufeinander auf.
Der Faden aus den Außenseitern und dem Satellitentest weist in eine Richtung: auf der Zieldomäne selbst vortrainieren. Die bestimmende Eigenschaft dieser selbstüberwachten Methoden ist, dass sie gar keine Annotationen brauchen — dasselbe Rezept könnte also auf dem großen Archiv unannotierter CT / MRT eines Hauses laufen und die Features nativ „medizinisch" sprechen lassen, mit nur einer Handvoll Annotationen obendrauf. Wir haben das Vortraining selbst nicht getestet; es bräuchte eine eigene Studie — und für klinischen Einsatz ordentliche Validierung und regulatorische Arbeit. Aber so wird aus einem Daten-Moat ein Modell-Moat.
Grenzen — das war ein schneller Blick, nicht das letzte Wort
- Eingefroren, nicht feinabgestimmt. Die Modelle an CT anzupassen würde deutlich mehr herausholen — umso mehr, je weiter der Input von Alltagsfotos entfernt liegt.
- Nur leichter 3D-Kontext. Schnitt-plus-gemittelte-Nachbarn schlug sowohl volle Konkatenation (überanpasst seltene Subtypen) als auch naives Mitteln (verwischt den Schnitt, schadete). Ein voll gelerntes Sequenzmodell über Schnitte hinweg — wie beim Gewinner — ist der verbleibende Weg zu mehr.
- Keine Eins-zu-eins-Leaderboard-Zahl. Alle Werte sind auf unserem eigenen patientenweise getrennten Split, nicht auf dem privaten Testset von 2019. Das „2,6-Fache" ist ein Plausibilitätscheck zur Größenordnung, kein direkter Vergleich.
Die Workflow-Zahlen oben stammen aus ausgerollten, validierten Systemen — nicht aus dieser Arbeit. Wir haben die Fähigkeit auf öffentlichen, unvollkommenen Daten demonstriert, ohne klinischen Einsatz und ohne klinische Studie. Daraus einen sicheren Zweitleser oder Verlegungs-Auslöser zu machen ist eine separate, ordentlich regulierte Anstrengung; es wird kein MDR/CE-Anspruch erhoben.
Falls Sie daran arbeiten: Die Bausteine sind heute da — sie einzusetzen braucht Engineering, keinen Durchbruch. Falls Sie klinische Bildgebungs-Workflows mit KI verbessern, mit den Domänendaten und der klinischen Reichweite, um es richtig zu tun, freue ich mich auf das Gespräch.