Rare-Disease AI: Welche Signale tragen wirklich?
Seltene Erkrankungen sind kein gewöhnliches Klassifikationsproblem. Wenige Fälle, viele mögliche Diagnosen und sehr unterschiedliche Datenquellen machen es leicht, beeindruckende Zahlen für die falsche Aufgabe zu erzeugen. Die Experimente zerlegen das Problem Schritt für Schritt. Moyamoya dient anschließend als konkreter Härtetest.
Bei häufigen Erkrankungen kann ein Modell aus vielen ähnlichen Beispielen lernen. Bei seltenen Erkrankungen fehlt genau diese Wiederholung. Oft gibt es nur einzelne Fallberichte, kleine Register oder verstreute Bilder. Gleichzeitig umfasst die mögliche Diagnose nicht zwei Klassen, sondern Hunderte oder Tausende Erkrankungen, die sich viele Symptome teilen.
Das verändert die zentrale Frage. Es reicht nicht zu fragen, welches Modell den höchsten Wert erreicht. Zuerst muss klar sein, welche Information dem Modell gezeigt wird, welcher Vergleich klinisch sinnvoll ist und ob das gelernte Signal tatsächlich zur Krankheit gehört. Ein sauber codierter HPO-Befund, ein ausformulierter Arztbrief und eine radiologische Abbildung beschreiben denselben Menschen auf völlig unterschiedliche Weise.
Drei Darstellungen desselben Falls
HPO-Codes funktionieren wie eine standardisierte Checkliste. „Kleinwuchs“, „Krampfanfall“ oder „Mikrozephalie“ werden als diskrete Merkmale eingetragen. Das erleichtert Vergleiche, entfernt aber Reihenfolge, Negation, zeitlichen Verlauf und viele diagnostische Nuancen.
Freie klinische Prosa ähnelt einem ausführlichen Übergabegespräch. Sie enthält Verlauf, Unsicherheit und Beziehungen zwischen Befunden. Gleichzeitig verraten Schreibstil, Klinik, Publikationsform und bereits erfolgte Diagnostik oft mehr als beabsichtigt.
Ein Bild ist näher an der ursprünglichen Beobachtung. Es zeigt Morphologie und räumliche Zusammenhänge, enthält aber auch Scannertexte, Zuschnitt, Modalität und Publikationslayout. Ein Encoder verwandelt diese Pixel zunächst in einen Zahlenvektor. Ein nachgeschaltetes lineares Modell lernt daraus eine einfache Entscheidungsgrenze.
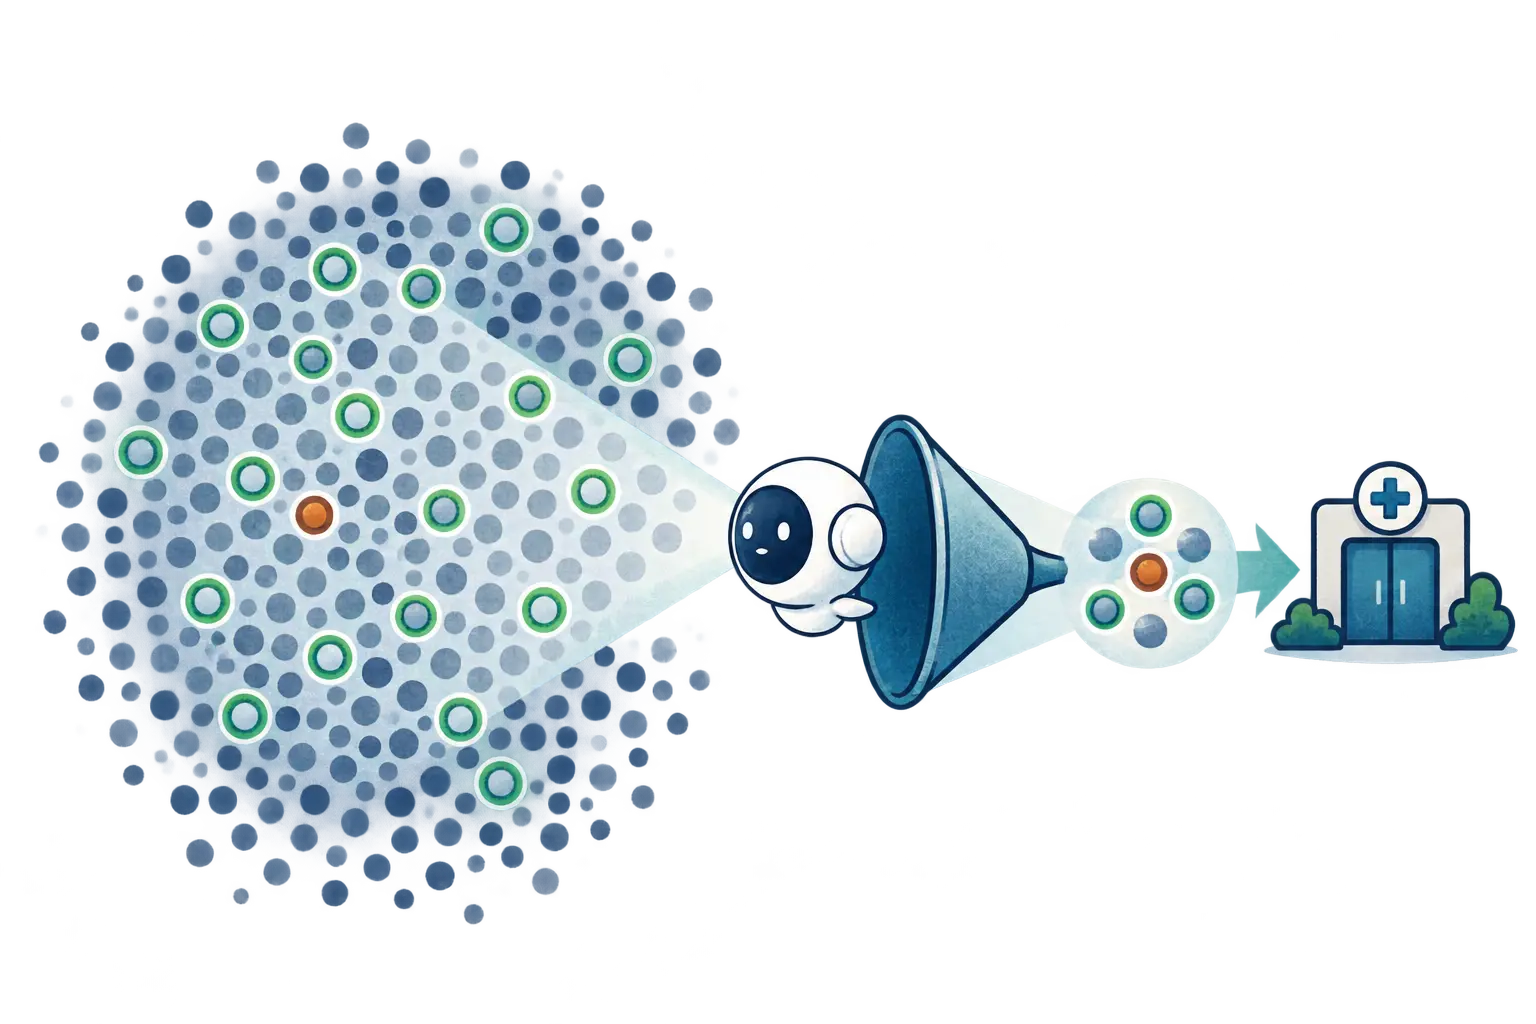
Leserichtung. Die ersten Kapitel erklären die allgemeinen Rare-Disease-Experimente. HPO ist der strukturierte Kontrollfall. Text und Bild zeigen, was bei unstrukturierten Daten hinzukommt. Ein Provenienztest prüft, ob das Modell Krankheit oder Datenherkunft erkennt. Erst danach folgt Moyamoya als ausführliches klinisches Beispiel.
Die Untersuchung in fünf Schritten
Die Untersuchung verbindet drei Fragen: Was lässt sich aus wenigen wiederkehrenden Fällen lernen? Wann tragen Text und Bilder diagnostische Information? Und kann ein gezielter Hinweis auf eine behandelbare Erkrankung eine fachärztliche Zweitprüfung auslösen? Grundlage sind öffentliche Forschungsdatensätze und eigens erzeugte Beispiele, keine gezeigten Patientendaten. Die Ergebnisse stammen aus unterschiedlichen Datensätzen und Aufgaben; ihre Kennzahlen sind nicht austauschbar.
1. Wiederkehrende Diagnosen verändern den Modellvergleich
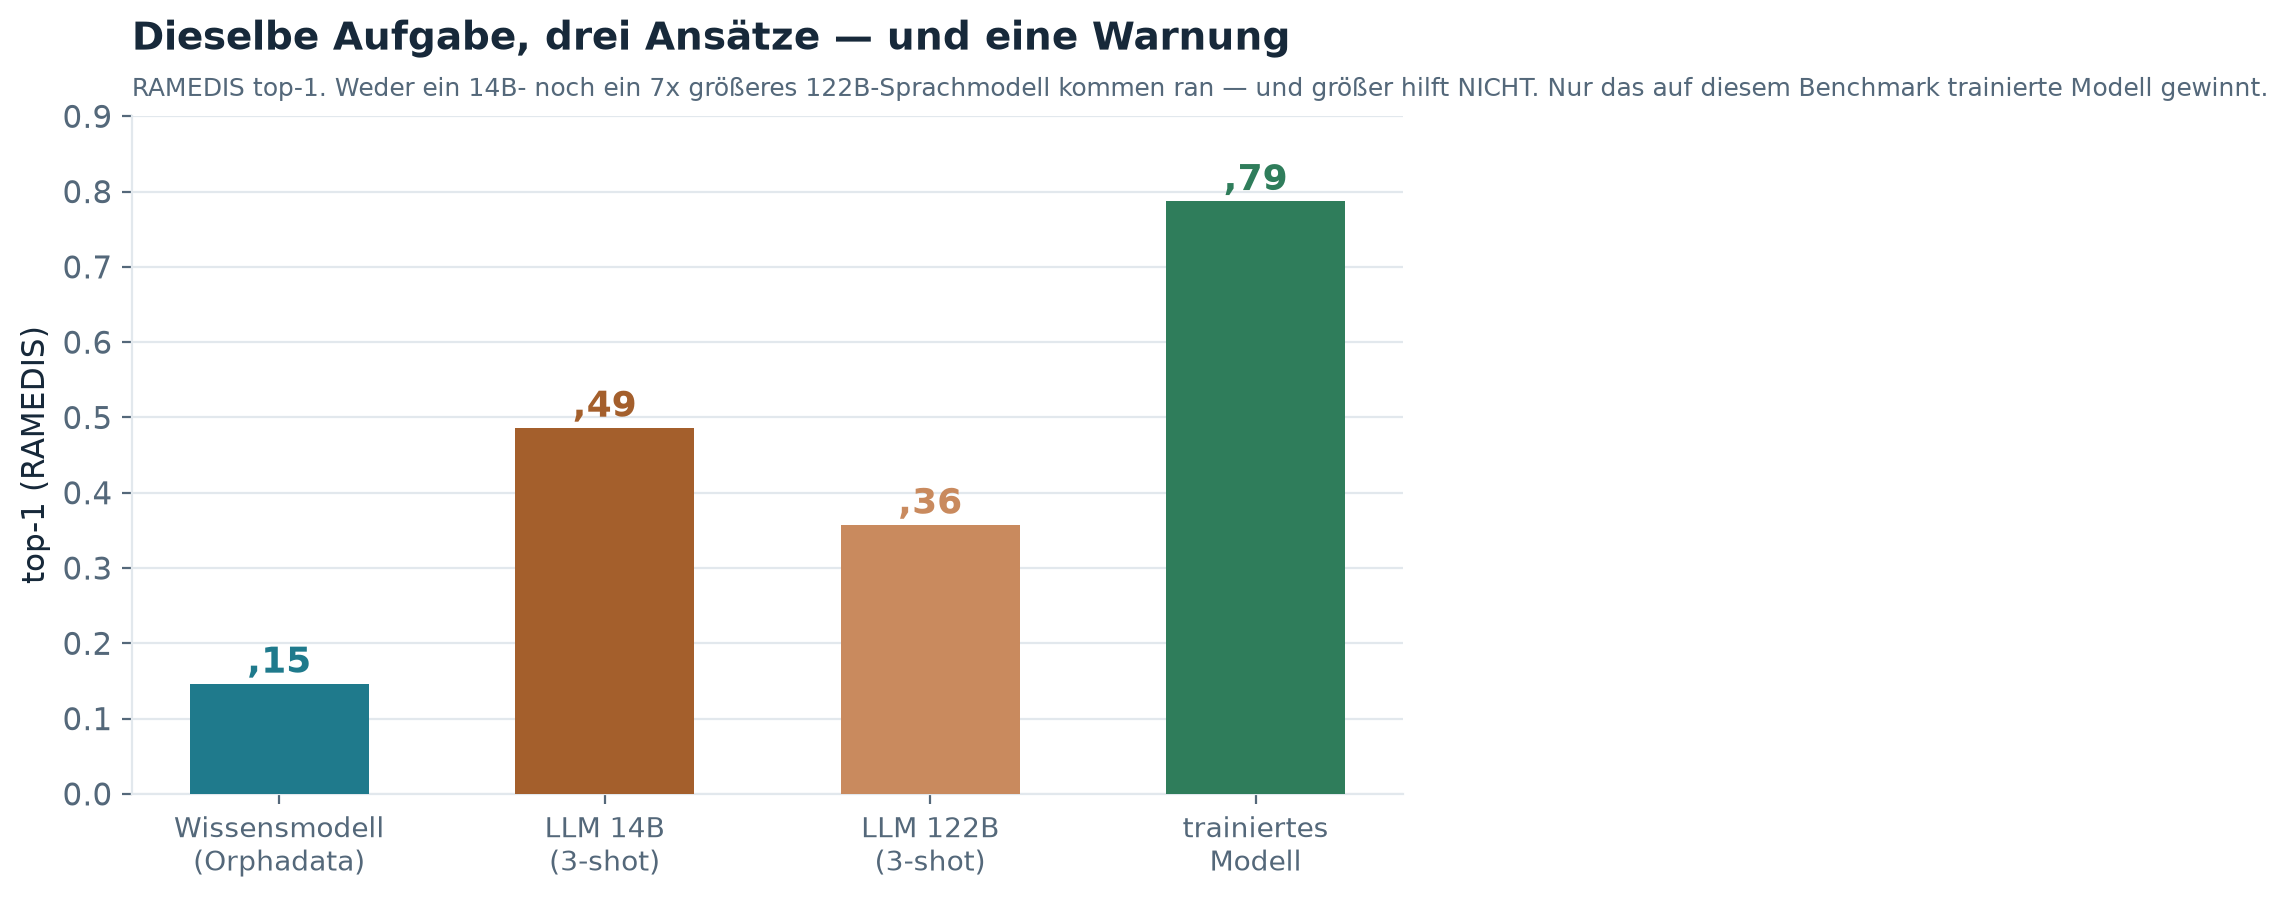
Im RareBench-Vergleich erhält ein eingefrorener Foundation Encoder eine dünne lineare Entscheidungsschicht. Auf der untersuchten HPO-Aufgabe erreicht dieser Probe ungefähr 0,80 Top‑1. Der wissensbasierte Lookup liegt bei etwa 0,15; die getesteten Sprachmodelle mit 14 und 122 Milliarden Parametern bei ungefähr 0,49 und 0,36. Das ist ein Ergebnis für diese Datenaufteilung, kein allgemeiner Beweis, dass kleine Modelle stets besser sind.
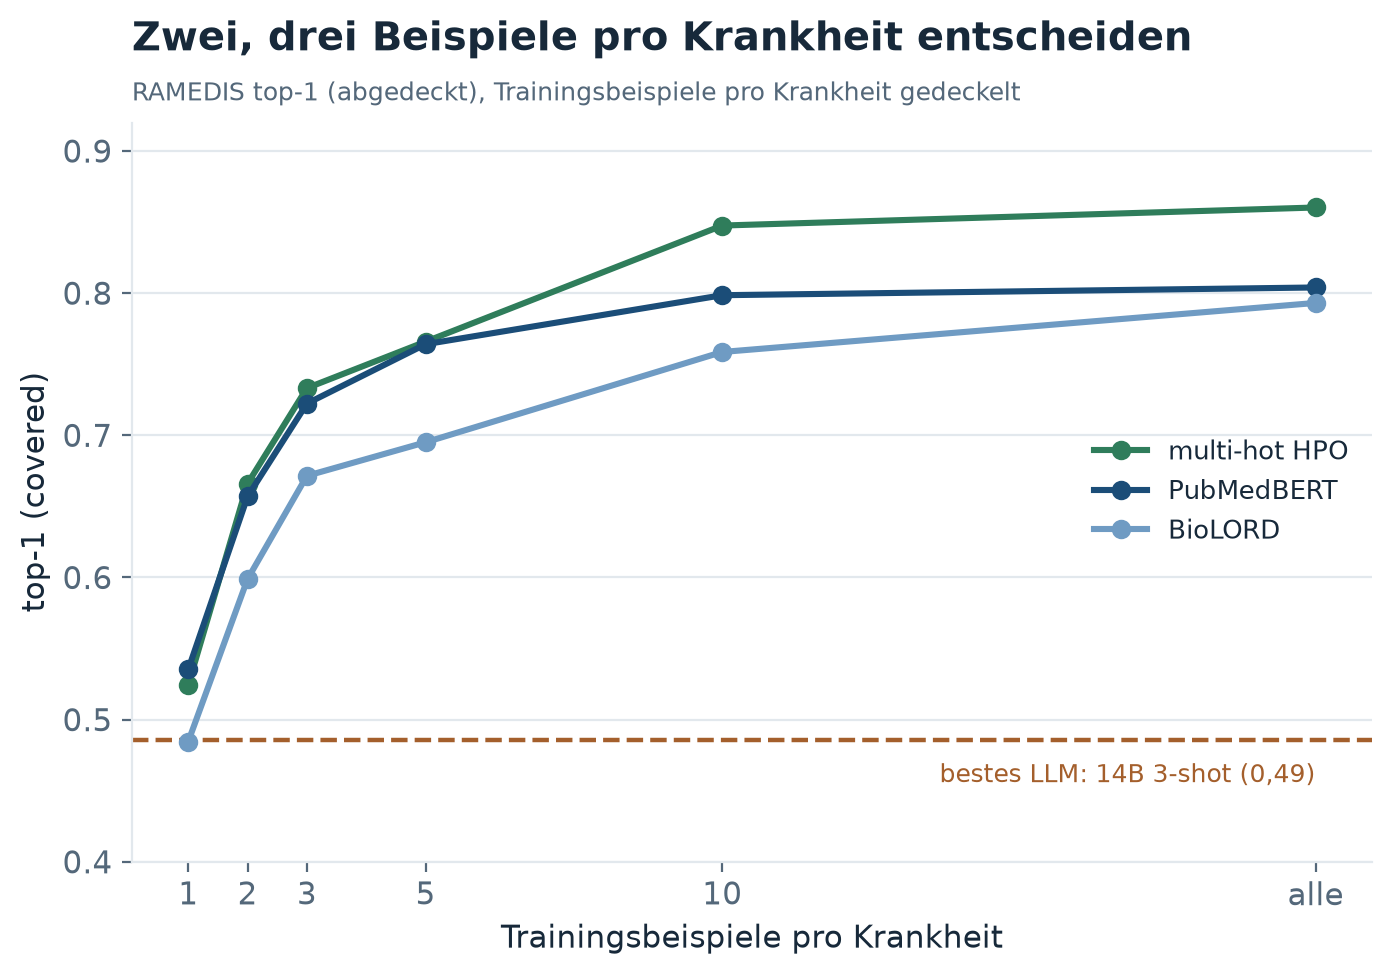
Der Vorteil setzt voraus, dass Diagnosen wiederkehren. Mit nur einem oder zwei Beispielen pro Krankheit überlappen die Verfahren innerhalb der Unsicherheit. Der Probe nutzt allgemeine Repräsentationen eines vortrainierten Encoders und passt mit wenigen Fällen die letzte Entscheidung an. Für echte Einzelfälle ohne vergleichbare Beispiele löst er den Datenmangel nicht.
2. Text und Bild helfen – aber nur mit Leckageprüfung
Im gepaarten MMRareBench-Vergleich aus 474 Fällen liegt Top‑1 für Text bei etwa 0,31, für Bilder bei 0,21 und für die Kombination bei 0,34. Der kleine Zugewinn durch Fusion ist plausibel: Text beschreibt den Verlauf, Bilder ergänzen sichtbare Merkmale. Doch ungefähr ein Drittel der Texte verrät die Diagnose indirekt – etwa über Abkürzungen oder bereits erfolgte Diagnostik. Der Textwert ist daher teilweise eine Obergrenze und kein sauberer prädiagnostischer Leistungsnachweis.
Bei der Moyamoya-Fallstudie ist die Textleckage noch deutlicher: Der rohe Berichtstext erreicht etwa 0,95 AUROC. Nach dem Schwärzen offensichtlicher Diagnosebegriffe bleibt etwa 0,90. Verwendet man nur die Vorgeschichte, die vor der Diagnose verfügbar wäre, fällt der Wert auf 0,47 – nahe am Zufall. Die hohe Rohtextzahl bildet also vor allem bereits erfolgte Diagnostik und den Kontext des Berichts ab.
3. Moyamoya als konkreter Prüfstein
Für den Bildversuch nutzt die Untersuchung offene Fallberichte aus MultiCaRe. Der Datensatz enthält keine fertigen Diagnoselabels. Nach einer Keyword-Vorauswahl wurden die Berichte geprüft; vorhergesagt wird nur aus der klinischen Vorstellung. Die Videoauswertung zählt 91 bestätigte Moyamoya-Fälle und 646 vaskuläre Vergleichsfälle. Bilder desselben Artikels bleiben im selben Split.
Das Bildmodell erreicht in dieser Auswertung etwa 0,86 AUROC; eine Metadaten-Baseline 0,59. Nach strengen Kontrollen – Kopfaufnahmen, farbige Pfeile entfernt, Ansichten angeglichen und Gefäßbilder ausgeschlossen – bleibt es bei etwa 0,84; im kleinsten Gewebe-Subset bei rund 0,77. Auf Gefäßbildern, der klinisch schwierigeren Unterscheidung von anderen Gefäßerkrankungen, liegt es bei etwa 0,71. Die kleinen Fallzahlen bedeuten breite Unsicherheit.
Drei Abkürzungen wurden gezielt geprüft: fremde Bildregionen, farbige Pfeile und unterschiedliche Aufnahmeansichten. Eine reine Metadaten-Baseline erreicht 0,59 AUROC. Nach Beschränkung auf Kopfaufnahmen, Entfernen markierter Bilder und Angleichung der Ansichten bleibt das Bildmodell bei etwa 0,84. Im strengsten Hirngewebe-Subset ohne Gefäßbilder sinkt es auf 0,77, allerdings mit nur 16 positiven Fällen. Auf Gefäßbildern selbst – der schwierigeren Unterscheidung von anderen Gefäßerkrankungen – liegt es bei etwa 0,71. Die Ergebnisse sprechen für ein Bildsignal, ihre Unsicherheit und die kleine Fallzahl bleiben zentral.
Alter und Geschlecht erreichen allein etwa 0,68 AUROC, das kontrollierte Bildsignal etwa 0,84. Für jüngere Fälle liegt es bei etwa 0,76, für altersangepasste atypische Fälle über 40 bei etwa 0,89 – mit nur rund zehn positiven Fällen je Gruppe. Das ist ein Hinweis für weitere Prüfung, kein Nachweis zuverlässiger Früherkennung.
Der faire Vergleich mit der klinischen Regel ist wichtig. Die grobe Regel „jung und zerebrovaskuläres Ereignis“ erreicht 0,62 Sensitivität bei 0,84 Spezifität. Ein gelerntes Modell auf denselben Merkmalen kommt bei gleicher Spezifität auf 0,65 und kann zusätzlich an einen anderen Arbeitspunkt angepasst werden. Davon getrennt erreicht Alter und Geschlecht als reine Ranginformation 0,68 AUROC, die kuratierte klinische Präsentation 0,81 und das kontrollierte Bildsignal 0,84. Die Werte beschreiben verschiedene Eingaben und Kennzahlen und dürfen nicht gleichgesetzt werden.
4. Ein Alarm soll eine Fachprüfung auslösen, keine Diagnose stellen
Bei sehr niedriger Prävalenz kann selbst ein brauchbarer Detektor viele Fehlalarme je echtem Fall erzeugen. Das Video rechnet beispielhaft mit etwa 120 fachärztlichen Prüfungen pro Treffer in Europa und etwa 13 in Japan. Vorgesehen ist eine stille Zweitprüfung bereits vorhandener Aufnahmen; die normale Versorgung läuft weiter, die Diagnose bleibt beim Expertenteam. Die Last hängt von Prävalenz und Arbeitspunkt ab.
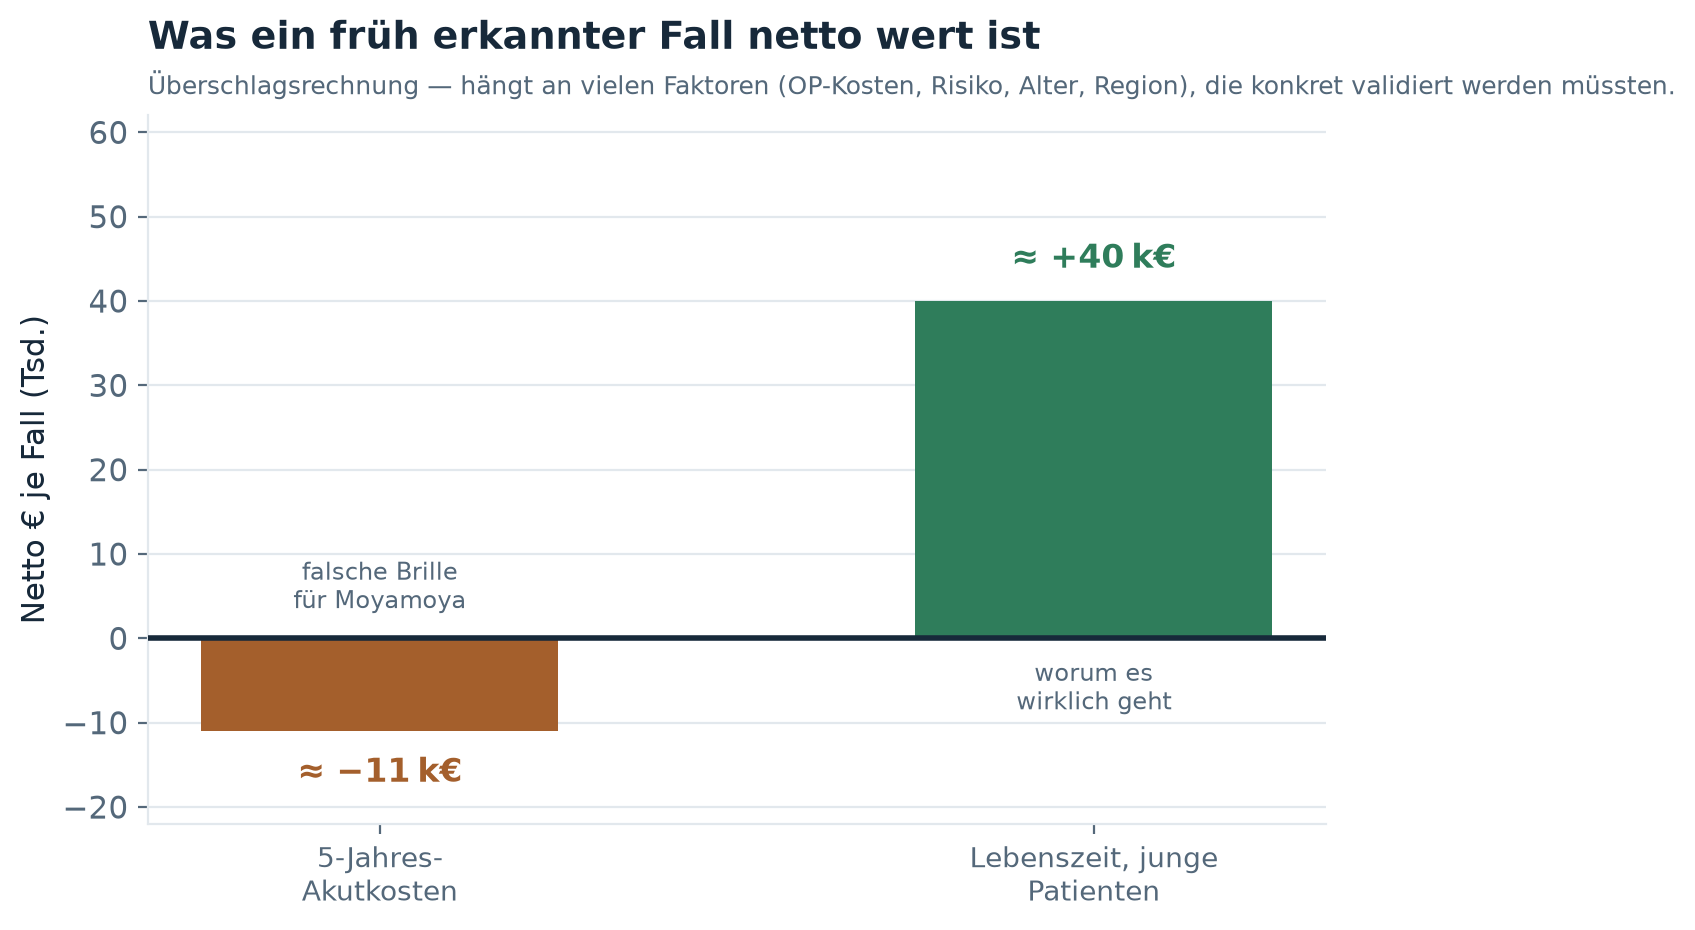
Ein illustratives Hochsensitivitäts-Szenario erhöht die modellierte Erkennung von 62 auf rund 87 Prozent und ergibt für ein japanisches Netzwerk etwa 38 zusätzliche frühe Hinweise pro Jahr. Eine grobe Wirtschaftlichkeitsrechnung schätzt rund 40.000 Euro möglichen Lebenszeitnutzen je zusätzlichem Fall. Beides sind annahmenbasierte Projektionen – keine gemessene Wirkung und keine gesundheitsökonomische Evaluation.
Die grobe Rechnung hängt stark vom Zeithorizont ab. Eine japanische Studie zu hämorrhagischer Moyamoya berichtet einen Rückgang erneuter Blutungen unter Bypass. Über fünf Jahre können vermiedene Schlaganfallkosten allein die Operationskosten noch nicht ausgleichen; der mögliche langfristige Nutzen entsteht vor allem, wenn bei meist jungen Betroffenen jahrzehntelange Behinderung vermieden wird. Die Größenordnung von rund 40.000 Euro pro Fall ist deshalb eine zu prüfende Annahme, kein belastbares Kosten-Nutzen-Ergebnis.
5. Was vor einem klinischen Einsatz fehlt
Ein möglicher Weg beginnt als Service: Ein einfacher klinischer Vorfilter sammelt Verdachtsfälle, Fachleute bestätigen oder verwerfen sie und erzeugen so saubere Labels. Darauf wird das Modell trainiert. Erst in einer späteren Phase sucht es zusätzliche Fälle außerhalb des Vorfilters und reicht sie zur Prüfung weiter. Vor einem Produkt braucht es eine prospektive Kohorte aus dem echten Klinikalltag – mit häufigen Schlaganfall-Mimics und tausenden gewöhnlichen Fällen. Synthetische Normalfälle können diese klinische Überlappung nicht ersetzen.
Publizierte Fallberichte sind selektiv und unvollständig. Es fehlt eine prospektive Kohorte aus der echten Versorgung mit häufigen Schlaganfall-Mimics. Synthetische Normalfälle können diese Überlappung nicht ersetzen. Nötig sind prospektiv gesammelte und fachärztlich bewertete Daten, externe Validierung, lokale Kalibrierung und eine Studie im realen Versorgungspfad. Erst dann lässt sich Nutzen und Sicherheit eines Medizinprodukts beurteilen.
Epidemiologie: Liu et al., Japan 2015–2019 · Birkeland, Denmark 2008–2017. Behandlung bei hämorrhagischer Moyamoya: Japan Adult Moyamoya Trial.
Vollständiges Sprechertranskript — 52 Abschnitte
01 · Die richtige KI für seltene Krankheiten
Stellen Sie sich vor, Sie sind seit Jahren krank, und niemand kann Ihnen sagen, was Sie haben. Für Menschen mit einer seltenen Krankheit ist das oft der Alltag — im Schnitt vergehen Jahre bis zur richtigen Diagnose. Die große Hoffnung heißt gerade künstliche Intelligenz. Aber welche KI hilft hier wirklich, und woran erkennt man das? Genau das schauen wir uns heute an, Schritt für Schritt und mit ehrlichen Zahlen. Eine Untersuchung von Sebastian Schmoll. Und ja, die Stimme, die Sie hören, ist selbst KI-generiert.
02 · Wie groß das Problem wirklich ist
Und hier lohnt der Blick auf die Größenordnung, denn das Wort „selten“ täuscht. Es gibt rund siebentausend verschiedene seltene Krankheiten. Einzeln trifft jede nur wenige — zusammen aber rund dreihundert Millionen Menschen weltweit, mehr als Krebs und AIDS zusammen, ungefähr jeder Siebzehnte. Für die Betroffenen beginnt meist eine regelrechte Diagnose-Odyssee: im Schnitt vier bis sieben Jahre, drei bis zehn Ärzte, oft mehrere Fehldiagnosen, bevor überhaupt ein Name feststeht. Und selbst dann gibt es für rund fünfundneunzig Prozent dieser Krankheiten keine zugelassene Therapie. Etwa siebzig Prozent beginnen im Kindesalter. Das ist kein Nischenproblem — es ist eine der größten ungelösten Fragen der Medizin. Genau deshalb ist die Hoffnung auf künstliche Intelligenz hier so groß.
03 · Kann man nicht einfach das Sprachmodell fragen?
Fangen wir mit der Idee an, die fast jeder zuerst hat. Man nimmt den ganzen Krankenbericht, kippt ihn in ein großes Sprachmodell wie ChatGPT und fragt einfach: Was hat dieser Patient? Das klingt bestechend. Aber hier wird es schwierig, und zwar aus einem konkreten Grund: Bei seltenen Krankheiten ist die Auswahl riesig — hunderte, tausende mögliche Diagnosen gleichzeitig — und für die meisten davon gibt es kaum Beispiele, aus denen irgendjemand lernen könnte. Statt zu raten, ob das funktioniert, messen wir es. Und zwar an echten, bereits gelösten Fällen, bei denen die richtige Antwort zweifelsfrei feststeht.
04 · Warum sich Dranbleiben lohnt
Bevor wir messen, drei Versprechen, warum sich das Dranbleiben lohnt. Erstens: Ein winziges, billiges Modell schlägt gleich das große Sprachmodell — unter einer Bedingung, die fast niemand ausspricht.
Zweitens: An einer echten, behandelbaren Krankheit — Moyamoya — sehen wir, wie eine KI Fälle Jahre früher aufspüren könnte, rechtzeitig für eine Operation, die Schlaganfälle verhindert.
Und drittens, das Unbequeme: Drei Fallen zerstören fast jede schöne KI-Zahl — Leckage, Grundrate und Datenherkunft. Wir prüfen jede schonungslos, und manche Zahl zerbricht dabei. Bleiben Sie dran.
05 · Woher die Daten kommen — öffentliche Forschungsdatensätze
Kurz, worauf das alles beruht: ausschließlich öffentliche, zitierbare Forschungsdatensätze, und alles tatsächlich gemessen. RareBench bündelt rund eintausendhundert Fälle als genormte Symptom-Codes mit gesicherter Diagnose. MMRareBench bringt vierhundertvierundsiebzig Fälle aus echten Klinik-Texten und publizierten Bildern. MultiCaRe liefert offene Fallberichte mit Bild und Text — daraus bauen wir später die Moyamoya-Fallstudie. Und Orphanet ist eine Wissensdatenbank mit über viertausend Krankheiten, für das Nachschlage-Modell. Echte Patientendaten zeigen wir nie, nur synthetische Beispiele. Fangen wir mit dem einfachsten Format an: den HPO-codierten Fällen.
06 · Fangen wir einfach an: ein HPO-codierter Fall
So sieht so ein Fall konkret aus. Jedes Symptom ist als genormter H P O-Code hinterlegt — Human Phenotype Ontology, ein einheitliches Wörterbuch für Krankheitszeichen, damit Krampfanfall immer dasselbe meint, egal welche Klinik es aufgeschrieben hat. Das Beispiel hier ist natürlich erfunden. Auf genau solchen Fällen messen wir jetzt die drei Ansätze.
07 · Drei Wege — auf denselben Fällen gemessen
Es gibt grob drei Wege, so eine Krankheit zu erkennen. Erstens ein trainiertes Modell, das aus gelösten Fällen die Muster lernt. Zweitens ein Wissensmodell, das in einer Art medizinischem Lexikon nachschlägt und gar keine eigenen Beispiele braucht. Drittens das große Sprachmodell von eben, direkt gefragt. Als Maß nehmen wir top-1: Steht die richtige Diagnose ganz oben auf Platz eins? Auf einem Datensatz mit vielen wiederkehrenden Diagnosen gewinnt das trainierte Modell klar, bei etwa null Komma acht — also acht von zehn richtig. Und damit das fair ist, haben wir das Sprachmodell gleich in zwei Größen gefragt — ein mittleres mit vierzehn Milliarden Parametern und ein siebenmal größeres mit hundertzweiundzwanzig Milliarden, beide mit Beispielen. Das überraschende Ergebnis: Das kleinere trifft sogar etwas besser, knapp die Hälfte, das riesige nur gut ein Drittel. Größer ist hier also nicht besser — und beide bleiben weit hinter dem trainierten Modell, während das reine Lexikon mit einem Siebtel ganz abreißt. Das ist eine faire Vergleichslinie, aber noch nicht der letzte Stand der Technik wie ein Frontier-Modell. Und trotzdem: Das mit Abstand kleinste, billigste Modell gewinnt. Warum, das sehen wir jetzt.
08 · Ein Beispiel — was sagt jeder Ansatz?
Machen wir es greifbar an einem erfundenen Fall — als HPO-Codes, genau wie das Modell ihn sieht: wiederkehrende Krampfanfälle, Entwicklungsverzögerung, eine Laktatazidose und eine schlaganfallartige Episode. Was sagt jeder Ansatz? Das Sprachmodell tippt vage auf eine mitochondriale Störung, landet aber selten exakt auf Platz eins. Das trainierte Probe-Modell, das ähnliche gelöste Fälle gesehen hat, nennt MELAS auf Platz eins. Das Wissensmodell findet mehrere passende Kandidaten, ohne klaren Sieger. Genau dieses Muster steckt hinter den aggregierten Zahlen von eben. Die Ausgaben hier sind nachgestellt, zur Veranschaulichung.
09 · Warum der Kleine gewinnt
Warum schlägt ein winziges Modell das riesige Sprachmodell? Der Trick ist einfacher, als man denkt, und er hat einen Namen: Wir bauen auf einem Foundation-Modell auf. Aber was ist das genau?
10 · Das Prinzip: fließender Mitarbeiter, kurze Einweisung
Ein Foundation-Modell ist ein Modell, das vorher einmal auf gewaltigen Datenmengen trainiert wurde und dadurch schon enorm viel Allgemeinwissen mitbringt. Stellen Sie sich einen neuen Mitarbeiter vor, der die Sprache schon fließend spricht und die Welt kennt — er muss nicht bei null anfangen.
Dieses riesige Vorwissen frieren wir ein. Eingefroren heißt: Wir verändern das große Modell nicht mehr, wir nutzen nur, was es ohnehin schon kann. Das spart Rechenzeit und, viel wichtiger, es spart Beispiele.
Obendrauf setzen wir nur einen hauchdünnen Entscheider, in der Fachsprache eine lineare Probe. Das ist nichts weiter als eine gewichtete Summe — das Modell lernt bloß, welche der vorhandenen Merkmale auf unsere Zielkrankheit hindeuten. Wie eine kurze Einweisung für genau einen Job, nicht ein ganzes Studium.
Und genau deshalb genügen schon zwei, drei Beispiele pro Krankheit, um das große Sprachmodell zu überholen. Das große Modell bringt das Verständnis mit, der dünne Aufsatz braucht nur noch den letzten Hinweis. Entscheidend ist einzig, ob überhaupt eine Handvoll Beispiele existiert.
11 · Zwei, drei Beispiele entscheiden
Dieses Bild zeigt es direkt. Nach rechts die Zahl der Beispiele pro Krankheit, nach oben die Trefferquote. Links, wo es fast keine Beispiele gibt, ist der kleine Spezialist chancenlos. Aber genau an der Stelle, wo zwei, drei Beispiele zusammenkommen, kippt es, und er zieht an der Vergleichslinie des großen Sprachmodells vorbei. Die Lehre ist versöhnlich: Wenig Daten sind kein Hindernis — solange es überhaupt ein paar sind. Das deckt sich übrigens mit einem früheren Befund von uns zu bildgebenden Modellen: Kleine, schlanke Modelle gewinnen genau dann, wenn Daten knapp sind.
12 · Aber Achtung — es kippt mit den Daten
Jetzt die Einordnung, die fast immer fehlt. Dieser klare Sieg gilt nur für einen Datensatz, in dem sich Diagnosen oft wiederholen — wie ein Lehrbuch, in dem dieselbe Krankheit auf vielen Seiten steht. Nimmt man Datensätze dazu, die eher wie eine Briefmarkensammlung sind, jede Krankheit ein Einzelstück, dann rücken alle drei Balken zusammen und ihre Fehlerbalken überlappen sich. Im Klartext: Der Unterschied ist dann statistisch gar nicht mehr sicher. Entscheidend ist also nicht die Methode allein, sondern wie oft eine Krankheit überhaupt wiederkehrt.
13 · Die offene Hälfte — und warum wir trotzdem weitermachen
Bleiben wir ehrlich: Für die wirklich einmaligen Fälle, die es nur ein- oder zweimal auf der Welt gibt, existieren keine Beispiele — und damit löst sie heute kein Ansatz zuverlässig. An dieser Stelle könnte man aufgeben. Das wäre die falsche Schlussfolgerung, denn wir müssen gar nicht jede seltene Krankheit erkennen. Manche sind viel lohnender als andere: nämlich die, für die es erstens eine wirksame Behandlung gibt und die zweitens häufig genug sind, dass ein paar Beispiele existieren. Für genau diese Teilmenge kippt das Problem von unlösbar zu machbar.
14 · Text, Bild oder beides? — Informationen zusammenführen
Verlassen wir den Einzelfall und schauen auf den allgemeinen Fall. Ein Patient hinterlässt selten nur einen Text — meist gehören auch Bilder dazu, ein M R T oder ein Mikroskop-Befund. Die Idee dahinter heißt Fusion: beide Informationsquellen zu EINER Entscheidung zusammenzuführen, statt sich auf eine zu beschränken. Testen wir es sauber auf vierhundertvierundsiebzig Fällen, die beides haben. Der geschriebene Fall allein trägt am meisten, rund einunddreißig Prozent Treffer — weil er den ganzen Verlauf erzählt.
Das Bild allein liegt darunter, bei rund einundzwanzig Prozent. Ein medizinisches Bild zeigt eben nur einen Moment, der Text die ganze Geschichte.
Und jetzt die Fusion — beide zusammengeführt. Das Modell legt die Hinweise aus Text UND Bild nebeneinander und entscheidet gemeinsam, wie zwei Ärzte, die ihre Notizen vergleichen: Sind sie einig, wird man sicherer; widersprechen sie sich, zählt, wem das Modell mehr vertraut. Das Ergebnis landet nur knapp über dem Text allein, bei vierunddreißig Prozent. Zusammenführen ist also der richtige Reflex — hier bringt es aber wenig, weil das Bild die Textliste nur in Einzelfällen umsortiert.
15 · Dürfen wir dem Text trauen? — der Leckage-Test
Eine Zahl ist nur so gut wie ihre Fairness. Die Gefahr bei Text heißt Leckage: Das Modell liest nicht die Symptome, sondern ein Wort, das die Antwort schon enthält. Der naive Test fragt: Steht der Diagnosename wörtlich im Falltext? Antwort: in nur null Komma vier Prozent. Klingt makellos sauber. Aber dieser Test ist zu gutgläubig — der Benchmark ersetzt den Diagnosenamen ohnehin durch einen Platzhalter, deshalb findet eine reine Wortsuche fast nie etwas.
Also haben wir genau das mit dem Experiment geprüft, das diesem Video zugrunde liegt: ein Sprachmodell liest jeden der vierhundertvierundsiebzig Fälle sinngemäß und urteilt, ob die Antwort auch ohne das exakte Wort durchscheint. Das Ergebnis ist unbequemer, als die Wortsuche vermuten ließ. In rund zwei Dritteln der Fälle stehen nur Symptome — da muss man wirklich schlussfolgern. Aber in etwa einem Drittel ist die Antwort stark telegrafiert: mal durch eine unmaskierte Abkürzung oder einen Eigennamen, mal durch einen Befund, der nur zu einer Krankheit passt. Im Klartext: Unsere frühere Annahme, der Text sei quasi sauber, war zu optimistisch — deshalb haben wir ja gemessen. Das Text-Ergebnis von eben ist echtes Signal, aber teils eine Obergrenze. Und genau darum bauen wir für den echten Fall gleich ein eigenes, sauberes Label und verlassen uns aufs Bild.
16 · Zwei Falltexte — und ob der Text petzt
Zwei erfundene Textschnipsel zeigen den Unterschied. Im ersten steht nur die Krankengeschichte — junge Frau, wiederkehrende Durchblutungsstörungen, beidseitige Gefäßverengungen; das Modell muss wirklich schließen, das ist faires Signal. Im zweiten taucht beiläufig die Formulierung ‚following the T S algorithm' auf — eine unmaskierte Abkürzung, die die Antwort, Tako-Tsubo, schon verrät. Genau solche Fälle machen jene rund fünfunddreißig Prozent aus. (Nachgestellt zur Veranschaulichung.)
17 · Die Idee: ein stiller Zweitleser im Hintergrund
Wie sieht der praktische Nutzen aus? So: ein stilles Modell, das im Hintergrund mitläuft, während ohnehin Befunde und Bilder entstehen. Es achtet nur auf eine kurze, kuratierte Liste behandelbarer, ausreichend häufiger Krankheiten. Und schlägt es an, flüstert es nicht bloß dem behandelnden Arzt zu. Es schickt den Fall — unabhängig von der Akutbehandlung, die ohnehin läuft — an einen angebundenen Experten für genau diese eine seltene Krankheit, der ihn gezielt zweitbegutachtet. Der akute Betrieb wird nicht gestört; parallel bekommt der Fall ein spezialisiertes zweites Paar Augen. Wichtig: Das ist ein Gedankenmodell, kein fertiges Medizinprodukt. Ob so ein Filter trägt, hängt an einer Zahl, die wir gleich ehrlich prüfen.
18 · Machen wir's konkret: Moyamoya
Nehmen wir eine echte Krankheit, die perfekt in dieses Raster passt: Moyamoya. Dabei verengen sich die großen Hirnarterien langsam, und der Körper baut sich als Notlösung ein feines Netz winziger Umgehungsgefäße. Unbehandelt drohen Schlaganfall oder Hirnblutung — auch bei Kindern und jungen Erwachsenen. Aber es gibt eine Operation, einen sogenannten Bypass, der das Risiko nachweislich senkt. Behandelbar und bildgebend erkennbar: Ein früher Hinweis kann hier Leben verändern.
19 · Das Gefäßmuster, schematisch
Damit Sie sehen, worum es geht, hier das Muster als Schema. Rechts ein gesundes Hirngefäß, das sich sauber verästelt. Links die kranke Seite: Die große Arterie ist verengt, fast dicht — und an ihrer Stelle wuchert ein feines Geflecht winziger Umgehungsgefäße. Dieses wolkige Netz erinnert an eine Rauchwolke, und genau das bedeutet Moyamoya auf Japanisch. Das Bild ist bewusst stilisiert und erzeugt, keine echten Patientendaten. In der Realität sehen die Fälle deutlich vielfältiger und unordentlicher aus: mal Magnetresonanz, mal klassische Angiografie, mal Computertomografie. Das Modell muss mit all dem zurechtkommen.
20 · Die Datenbasis für Moyamoya — ehrlich offengelegt
Und jetzt völlig offen, worauf das Modell trainiert — gerade weil das die halbe Miete ist. Die Daten stammen aus MultiCaRe, einem publizierten Datensatz aus offenen Fallberichten. Wichtig und offen gesagt: Dieser Datensatz liefert Bilder, Texte und Modalitäts-Angaben, aber kein fertiges Diagnose-Label. Welche Fälle Moyamoya sind, mussten wir also selbst bestimmen — wie, zeige ich gleich. Am Ende sind es einundneunzig bestätigte Moyamoya-Fälle gegen sechshundertsechsundvierzig Vergleichsfälle. Und entscheidend: Wir trennen nicht gegen gesunde Gehirne, sondern gegen Gefäß-Mimics wie Dissektion oder Vaskulitis, die auf dem Bild täuschend ähnlich aussehen. Das ist die schwere, faire Aufgabe.
21 · Wie wir das Label überhaupt bekommen
Also, wie bestimmt man das Label, wenn der Datensatz keines mitliefert? Der naive Weg wäre, einfach jeden Text zu nehmen, der das Wort Moyamoya enthält. Genau das haben wir zuerst getan, als groben Vorfilter — aber dieses Keyword-Verfahren ist verrauscht: Ein Fünftel dieser Treffer erwähnte Moyamoya bloß im Differenzial oder in einem Review, war also gar kein echter Fall.
Deshalb der saubere Schritt: Wir lassen ein Sprachmodell jeden Fallbericht wirklich lesen und entscheiden, ob dieser Patient tatsächlich mit Moyamoya diagnostiziert wurde. Das Label kommt aus dem ganzen Report inklusive Diagnose; die Merkmale, mit denen wir später vorhersagen, nur aus der Präsentation — also keine Zirkularität.
Danach filtern wir die Bilder sauber nach Region, Ansicht und Farbe, und teilen schließlich nach Artikel, damit keine zwei Bilder desselben Falls in Training und Test rutschen. Erst auf dieser aufbereiteten Basis messen wir.
22 · Schaut das Modell wirklich auf die Gefäße?
Bevor wir irgendeiner Zahl trauen, eine ernste Frage. Erkennt das Modell wirklich die Krankheit, oder schummelt es, indem es am Bildrand oder am Layout einer bestimmten Klinik erkennt, woher ein Bild stammt? Das wäre, als würde ein Schüler die richtige Antwort nicht wissen, aber am Wasserzeichen des Arbeitsblattes erkennen, aus welchem Lösungsbuch es kommt.
Dagegen setzen wir einen Test. Wir greifen gezielt ins Bild ein. Einmal zeigen wir nur die Gefäßregion — das räumliche Muster bleibt also erhalten. Einmal zerschneiden wir das Bild in vier Kacheln und betrachten jede für sich — das zerreißt den durchgehenden Gefäßverlauf.
Die Hypothese ist klar: Wenn das Modell wirklich das zusammenhängende Gefäßmuster liest, muss seine Leistung einbrechen, sobald wir diesen Zusammenhang zerschneiden. Bleibt sie dagegen gleich, hat es wohl etwas anderes gelernt, etwas Verräterisches.
23 · Woher das Bildsignal kommt
Und genau das passiert. Kurz, was A U R O C bedeutet: Es misst die Trennschärfe — wie gut das Modell Kranke von Nicht-Kranken trennt. Null Komma fünf ist reines Raten, eins Komma null wäre perfekt. Das volle Bild und die reine Gefäßregion liegen oben, bei rund null Komma acht fünf bis acht sechs. Die zerschnittenen Kacheln fallen deutlich ab, weil ihnen der Gefäßverlauf fehlt. Dieses Muster ist der Beweis: Das Modell schaut auf die richtige Sache, die echte Gefäß-Morphologie, nicht auf einen Trick am Bildrand.
24 · Die härteste Gegenprobe: raus mit den Confounds
Jetzt die schärfste Prüfung der ganzen Fallstudie, und sie entstand aus echten Verdachtsmomenten beim Blick in die Bilder. Drei Fallen lauern: Manche Vergleichsbilder sind gar keine Hirnbilder, sondern Thorax oder Hals. Auf manchen Positiven zeigt ein nachträglich eingezeichneter Pfeil auf den Befund. Und Positive sind häufiger Gefäß-Aufnahmen, Negative eher normale Schnittbilder. Jede dieser Fallen könnte das Modell als Abkürzung missbrauchen. Setzen wir eine Grenze: Ein Modell nur auf Metadaten, also Modalität und Anzahl der Abbildungen, kommt auf null Komma fünf neun. So weit trägt der reine Verteilungs-Trick.
Das Bildmodell auf dem sauberen LLM-Label liegt bei null Komma acht sechs — klar über der Metadaten-Grenze.
Jetzt die scharfe Gegenprobe: Wir behalten nur Kopf-Scans, löschen jede Abbildung mit farbigen Pfeilen, gleichen die Ansicht an und werfen sogar alle Gefäßbilder raus — übrig bleibt reines Hirngewebe. Und das Entscheidende: Die Zahl fällt kaum, sie hält bei null Komma acht vier. Die Confounds waren also nicht der Treiber, das Signal steckt wirklich im Gewebe. Die eigentliche Grenze bleibt die kleine Fallzahl, nur sechzehn Positive in dieser strengsten Teilmenge, also ein breites Vertrauensintervall.
25 · Zwei getrennte Klassifikatoren — der ehrliche Vergleich
Fasst man es als zwei getrennte Klassifikatoren, nicht vermischt: Auf dem reinen Hirngewebe trennt das Modell Moyamoya von den anderen Fällen mit null Komma acht vier.
Und auf den reinen Gefäßbildern, wo es die eigentlich spannende Aufgabe hat — das Moyamoya-Muster von anderen Gefäßkrankheiten wie Dissektion oder Atherosklerose zu unterscheiden — schafft es null Komma sieben eins. Gerade diese klinisch schwerste Unterscheidung ist nur moderat. Beide Zahlen sind echt, beide bescheiden, und das Vertrauensintervall ist breit, weil es nur rund drei Dutzend bestätigte Fälle gibt.
26 · Kein Glückstreffer: robust über zwölf Bild-Encoder
Damit es nicht am Zufall eines einzelnen Modells liegt, haben wir zwölf verschiedene Bild-Encoder geprüft. Ein Encoder ist der Baustein, der ein Bild in Zahlen übersetzt, mit denen ein Modell rechnen kann. Der beste, ein kleines DINOv2, liegt bei null Komma acht fünf.
Ein neueres DINOv3 folgt bei null Komma acht zwei.
Die mittelgroßen Varianten liegen um null Komma acht.
Auch die großen bleiben in diesem Bereich — größer ist hier nicht besser.
Und selbst das schwächste, ein medizinisch vortrainiertes Modell, liegt noch bei null Komma sieben zwei. Wichtig zur Einordnung: Das sind die rohen, noch nicht entkonfundierten Zahlen — sie zeigen nur, dass der Effekt kein Glückstreffer eines einzelnen Modells ist. Die belastbare Zahl ist die confound-kontrollierte von der Gegenprobe: Wenn wir Nicht-Hirnbilder, eingezeichnete Pfeile und Ansichts-Unterschiede herausrechnen, bleibt die Trennschärfe bei null Komma acht vier. Erst im allerstrengsten Schnitt — nur reines Hirngewebe, jedes Gefäßbild entfernt, nur noch wenige Fälle — sinkt sie auf null Komma sieben sieben. Beide Male also echtes Signal, keine Artefakte.
27 · Das Bild schlägt die reine Demografie
Und jetzt die faire Einordnung gegen die Demografie. Alter und Geschlecht allein, robust über alle Fälle gemessen, trennen Moyamoya mit null Komma sechs acht.
Das Bild dagegen — und zwar fair gerechnet, also confound-kontrolliert — trennt mit null Komma acht vier, klar besser als die reine Demografie. Das Bild lernt also nicht bloß, wer typischerweise betroffen ist, sondern trägt echtes Zusatz-Signal aus dem Hirngewebe. Moyamoya trifft zwar gehäuft junge Frauen, aber darauf reduziert sich das Bildsignal nicht.
28 · Der Patient, den die Heuristik übersieht
Und damit zur spannendsten Frage überhaupt: Was ist mit dem Patienten, der nicht ins Schema passt? Dem älteren, bei dem niemand zuerst an Moyamoya denkt? Genau dort entscheidet sich, ob ein Bildmodell echten Mehrwert hat oder nur die Demografie nachplappert.
29 · Aber: das Bild glänzt genau dort, wo die Demografie versagt
Und jetzt die Wendung, die den eigentlichen Wert zeigt. Trennen wir nach Alter. Bei den jungen Patienten, die eine Alters-Heuristik ohnehin flaggt, ist das Bild nur mäßig, null Komma sieben sechs — hier bringt es wenig Zusatznutzen gegenüber der Regel.
Aber bei den älteren, atypischen Patienten — alters-gematcht, sodass die Demografie nichts mehr verrät — springt das Bild auf null Komma acht neun. Genau dort, wo die simple Regel blind ist, trägt das Bild am meisten, vermutlich weil ältere Fälle mehr etablierte Gewebeschäden zeigen. Das Bild lernt also nicht bloß jung gleich Moyamoya nach, es ergänzt die Demografie dort, wo sie versagt. Zur Einordnung: nur rund zehn Positive je Gruppe, also breites Vertrauensintervall, aber die Richtung ist klar und klinisch sinnvoll.
30 · Der atypische Fall — was jeder Ansatz sagt
Und zum Kern der Fallstudie, ganz konkret. Ein erfundener, aber typisch schwieriger Fall: achtundvierzig Jahre, also eigentlich zu alt für den klassischen Verdacht, ein Routine-MRT nach einer vorübergehenden Durchblutungsstörung. Die einfache Demografie-Regel sagt: nicht jung, kein Verdacht — und übersieht ihn. Die Bild-KI auf dem Gewebe schlägt an und legt ihn dem Facharzt vor. Bestätigt die Gefäßdarstellung das Muster, ist der Fall früh erkannt. Genau dort, beim atypischen Patienten, liegt der Mehrwert. (Nachgestellt.)
31 · Und der Text? Verdächtig gut — hier schlägt die Leckage zu
Erinnern Sie sich, dass MMRareBench-Text sauber war? Bei Moyamoya ist es das genaue Gegenteil — deshalb prüft man es eben pro Datensatz. Der rohe Falltext trennt Moyamoya mit einer Trennschärfe von null Komma neun fünf, fast perfekt, besser als das Bild. Das ist verdächtig gut, also schälen wir Schicht für Schicht das Verräterische heraus.
Erste Schicht: Wir schwärzen die offensichtlichen Diagnostik-Begriffe, etwa den Namen der Operation. Die Zahl fällt auf null Komma neun.
Und der Clou: Bleibt nur die echte Vorgeschichte übrig, das, was man vor der Diagnose wüsste, fällt die Zahl auf null Komma vier sieben — ein Münzwurf. Die stärksten Wörter waren japanisch und Begriffe der bereits abgeschlossenen Untersuchung. Das Modell hat erraten, wer der Patient ist, und die fertige Diagnostik mitgelesen. Hier war fast alles Leckage.
32 · Vorsicht vor der schönen Zahl
Bevor wir über Nutzen reden, eine Warnung, die den meisten Erfolgsmeldungen fehlt. Schauen wir, was dieses Bild zeigt: Für jede einzelne seltene Krankheit haben wir einen eigenen kleinen Detektor gebaut — jeder Balken hier ist genau so einer. Seine Aufgabe: diese eine Krankheit von den anderen seltenen im Datensatz unterscheiden. Und fast jeder Balken steht nahezu ganz oben, die allermeisten über null Komma neun fünf — eine ganze Wand aus Bestnoten. Klingt gelöst. Ist es aber nicht — und der nächste Schritt zeigt, warum.
33 · Aber die Aufgabe war zu leicht
Gegen wen hat der Detektor gewonnen? Stellen Sie sich einen Türsteher vor, der dreißig Stammgäste blind auseinanderhält, fehlerfrei. Beeindruckend — nur ist das ein leerer Raum mit genau diesen dreißig. Genau das war die Aufgabe hier: eine seltene Krankheit von anderen seltenen trennen, die völlig anders aussehen.
Die echte Aufgabe ist eine andere: diesen einen Stammgast in einem vollen Stadion aus zehntausend Fremden erkennen. Also die seltene Krankheit zwischen tausenden ganz gewöhnlichen Patienten herausfischen. Gegen diese realistische Mischung fällt die Trennschärfe von fast perfekt auf null Komma sieben bis acht.
34 · Was ein Alarm wirklich kostet — die Grundrate
Und selbst diese null Komma sieben bis acht sind im Alltag trügerisch — wegen der Grundrate, also schlicht, wie selten die Krankheit überhaupt vorkommt. Was diese Kurve zeigt: Je seltener die Krankheit nach links, desto winziger der Anteil echter Treffer unter allen Alarmen. Rechnen wir es für Moyamoya in Europa konkret durch, am gewählten Arbeitspunkt. Damit das Modell neun von zehn echten Fällen erwischt, muss ein Facharzt rund hundertzwanzig geflaggte Scans durchsehen, um einen einzigen echten Moyamoya-Fall zu finden. Hundertzwanzig zu eins. Die bloße Seltenheit schlägt die gute Trennschärfe — das ist reine Wahrscheinlichkeitsrechnung und gilt für jede seltene Krankheit. An dieser Stelle würden die meisten das Projekt begraben. Zu Unrecht, wie die nächsten drei Schritte zeigen.
35 · Das Modell ersetzt niemanden — es reicht weiter
Bevor wir uns an der Grundrate verzweifeln, der entscheidende Perspektivwechsel: Dieses Modell muss gar keine Diagnose stellen. Es muss nur den richtigen Fall an den richtigen Menschen weiterreichen.
36 · Es muss keine Diagnose stellen — nur flaggen
Und genau hier entschärft sich die Grundrate. Der Trick ist nicht, weniger Fehlalarme zu haben — sondern sie billig zu machen. Weil das Modell keine Diagnose stellt, sondern einen ohnehin gemachten Scan nur als verdächtig markiert, kostet ein Fehlalarm bloß einen zusätzlichen Facharzt-Blick. Kein falsches Urteil, kein Schaden. Damit sind selbst hundertzwanzig Prüfungen pro echtem Fall tragbar statt fatal — es ist Facharzt-Zeit, kein Risiko.
Bei Alarm entscheidet, wie heute auch, ein Facharzt; die normale Behandlung des Patienten läuft völlig unbeeinflusst parallel weiter. Das Modell ersetzt niemanden und diagnostiziert nichts — es ist nur ein zweites Paar Augen, das sonst gefehlt hätte.
Und daraus folgt ein zweiter, davon unabhängiger Vorteil. Weil das Modell nur markiert, muss es gar nicht verstehen, warum jemand Moyamoya hat — eine bloße Korrelation genügt, keine Kausalität. Das ist kein Freibrief, aber es senkt die klinische und regulatorische Hürde deutlich gegenüber einem System, das selbst diagnostiziert. Die Datenknappheit von vorhin löst das übrigens nicht — die haben wir getrennt gelöst, indem wir uns auf behandelbare, wiederkehrende Krankheiten beschränken.
37 · Derselbe Algorithmus, völlig anderer Wert
Und jetzt der Hebel, der aus einer unbrauchbaren eine wertvolle Lösung macht: die Geografie. Moyamoya ist in Japan rund dreißigmal häufiger als in Europa. Am exakt gleichen Arbeitspunkt, mit demselben Modell, fällt damit die Last von rund hundertzwanzig Nachprüfungen pro echtem Fall auf nur noch etwa dreizehn. Dreizehn geflaggte Scans durchsehen, um einen echten Moyamoya-Fall früh zu finden — das ist auf einmal völlig im Rahmen dessen, was ein spezialisiertes Zentrum leisten kann.
38 · Der Business-Case, aufgeschlüsselt
Schlüsseln wir den ganzen Business-Case auf. Erstens die Menge: Ein Versorgungsnetz für sieben Komma sechs Millionen Menschen sieht bei japanischer Häufigkeit rund hundertfünfzig neue Moyamoya-Fälle im Jahr — in Europa wären es nur etwa fünf. Zweitens die Last: In Japan muss ein Facharzt pro echtem Fund nur rund dreizehn geflaggte Scans sichten, in Europa hundertzwanzig. Drittens die Ausbeute: Beim gewählten Arbeitspunkt erwischt das Modell neun von zehn Fällen. Und viertens, das Entscheidende: Moyamoya ist behandelbar. In einer Studie zu blutungsbedingtem Moyamoya sank die jährliche Rückblutungsrate mit einem direkten Bypass deutlich. Setzen wir das zusammen: hundertfünfzig früh geflaggte Fälle im Jahr, mit vertretbarem Prüfaufwand, die eine Operation auslösen, die Schlaganfälle verhindert. Das ist kein schöner Benchmark mehr — das ist ein Grund, so etwas tatsächlich in einem japanischen Zentrum zu bauen.
39 · Wo greift die KI im Klinik-Alltag ein?
Machen wir es ganz konkret: Wie fügt sich so ein Modell in den echten Klinik-Alltag ein? Der Schlüssel ist, dass die entscheidenden Daten ohnehin anfallen. Schauen wir den Weg eines Patienten entlang.
40 · Der Moyamoya-Weg — und wo KI überall eingreifen könnte
Schauen wir uns den typischen Weg eines Moyamoya-Patienten an. Am Anfang stehen Symptome, oft eine vorübergehende Durchblutungsstörung oder ein Schlaganfall. Deshalb wird ein Routine-Scan gemacht, ein CT oder MRT, der ohnehin entsteht. Ein Radiologe befundet ihn — und hier gehen subtile Fälle verloren. Erst bei Verdacht folgt die dedizierte Gefäßbildgebung, dann die Diagnose durch den Facharzt und schließlich der Bypass, der das Schlaganfallrisiko senkt.
Und jetzt sieht man, dass KI an mehreren ganz verschiedenen Stellen eingreifen könnte, je nach Datengrundlage. Eine Text-KI auf der Anamnese flaggt schon nach der Schilderung. Eine Bild-KI auf dem Routine-Scan fängt genau die Fälle, die der Radiologe übersieht. Und eine Gefäß-KI auf der Angiografie trennt das Moyamoya-Muster von anderen Gefäßkrankheiten. Wie stark jede Stelle ist, sehen wir gleich im Detail.
41 · Status quo vs. gelerntes Modell — fair gemessen
Bevor wir über KI-Mehrwert reden, die unbequemste aller Fragen: Schlägt ein gelerntes Modell überhaupt die einfache Regel, die Kliniker heute schon anwenden? Dafür haben wir die klinische Verdachtsregel selbst als Klassifikator implementiert und auf denselben Testdaten gemessen.
42 · Schlägt das Modell die klinische Regel?
Die heutige Regel, grob: junger Patient mit einem zerebrovaskulären Ereignis, dann an Moyamoya denken. Als Klassifikator fängt sie null Komma sechs zwei der Fälle, bei einer Spezifität von null Komma acht vier. Also: Fast vier von zehn Moyamoya werden von dieser simplen Regel übersehen.
Unser gelerntes Modell auf denselben Features fängt bei exakt gleicher Spezifität null Komma sechs fünf — also etwas mehr. Der eigentliche Vorteil ist aber: Das Modell hat einen frei wählbaren Arbeitspunkt, die Regel ist ein fixer Punkt. Man kann also bewusst mehr Sensitivität gegen mehr Fehlalarme eintauschen, je nach Bedarf.
43 · Je weiter im Weg, desto mehr Daten — und desto stärker
Gehen wir die Ansatzpunkte der Reihe nach durch — alle als Trennschärfe, als A U R O C. Ganz am Eingang, wenn der Fall reinkommt, hat man nur die Demografie, Alter und Geschlecht. Die trennt für sich schon mit null Komma sechs acht. Wichtig zur Abgrenzung: Das ist nicht die klinische Verdachtsregel von eben — die, jung plus Ereignis, haben wir separat als Klassifikator gemessen und als Sensitivität angegeben. Hier geht es um die rohe demografische Grundneigung als Trennschärfe.
Kommt die Anamnese dazu, also die saubere klinische Präsentation, steigt es auf null Komma acht eins — und das ganz ohne verräterische Rohtext-Wörter, nur mit kuratierten Features.
Bei einem Schlaganfall-Verdacht ist das allererste Bild ein Nativ-CT. Auch darauf könnte man eine KI trainieren, die schon hier Moyamoya-Hinweise flaggt. Für Moyamoya haben wir das noch nicht quantifiziert, aber es ist ein naheliegender, sehr früher Ansatzpunkt. Übrigens: Foundation-Modelle auf genau solchen Nativ-CTs, allerdings für Hirnblutungen, haben wir in einem eigenen Beitrag untersucht — den finden Sie verlinkt unter dem Video.
Auf dem regulären Schnittbild liegt die Bild-KI, confound-kontrolliert, bei null Komma acht vier — und, der entscheidende Punkt, bei null Komma acht neun für die atypischen, älteren Patienten, die die Demografie-Regel verpasst.
Und bei der Angiografie, mit den Gefäß-Features wie der bilateralen Stenose, steigt es auf null Komma acht sechs. Das ist aber schon bestätigend, denn die Angiografie macht man erst, wenn der Verdacht ohnehin da ist.
Und darüber hinaus gäbe es weitere Quellen, Genetik oder Labor, die wir hier gar nicht ausgereizt haben. Die Kernaussage: Je später im Weg, desto mehr Daten und desto stärker — aber je früher man flaggt, desto breiter und billiger greift man ein.
44 · Der Detektions-Funnel — wie viele Fälle zusätzlich
Setzen wir alles zu einem Fluss zusammen, mit gemessenen Zahlen. Von rund hundertfünfzig Moyamoya-Fällen im Jahr fängt die heutige klinische Regel etwa dreiundneunzig — ihre Sensitivität ist null Komma sechs zwei. Rund siebenundfünfzig werden übersehen, vor allem die atypischen, älteren. Genau deren Routine-Scans existieren aber schon, und darauf ist die Bild-KI am stärksten, null Komma neun bei den Atypischen. Bei einem hochsensitiven Arbeitspunkt fängt sie davon den Großteil, grob achtunddreißig zusätzliche Fälle, und legt sie dem Facharzt vor. Die Angiografie macht man dabei nur bei den geflaggten Hoch-Verdachts-Fällen. Unterm Strich steigt die Erkennung von etwa zweiundsechzig auf rund siebenundachtzig Prozent — ohne einen einzigen zusätzlichen Scan. Das Ganze unter der Annahme einer realistischen Fallverteilung, und es ist eine explorative Rechnung, kein Zulassungsnachweis.
45 · Was die zusätzlichen Fälle wert sind
Und was ist so ein zusätzlich früh erkannter Fall eigentlich wert? Rechnen wir es grob überschlägig durch — mit belastbaren Eckdaten, aber vielen Annahmen, die man konkret erheben müsste. Der Bypass senkt laut der japanischen Moyamoya-Studie die Ereignisrate über fünf Jahre deutlich, von rund vierunddreißig auf vierzehn Prozent. Setzt man das gegen die reinen Akutkosten eines Schlaganfalls — grob dreiundvierzigtausend Euro über die Lebenszeit — und zieht die Operationskosten ab, bleibt auf enger Fünf-Jahres-Sicht sogar ein kleiner Zuschuss, etwa minus elftausend Euro. Aber genau das ist die falsche Brille für Moyamoya. Denn Moyamoya trifft meist junge Menschen, und ein verhinderter behindernder Schlaganfall spart nicht fünf Jahre, sondern Jahrzehnte an Pflege, verlorener Arbeitskraft und Lebensqualität. Rechnet man das ein, liegt der Nettonutzen klar im Plus, in der Größenordnung von mehreren zehntausend Euro pro Fall. Ganz deutlich: Das ist eine Überschlagsrechnung, kein gesundheitsökonomisches Gutachten — die echten Zahlen hängen an Operationskosten, Risiko, Alter und Region und müssten konkret validiert werden. Aber die Richtung ist eindeutig: Der Wert steckt in der langfristig vermiedenen Behinderung junger Patienten.
46 · Wie man das ausrollt — vom Service zum Medizinprodukt
Wie würde man das konkret aufbauen, ohne am ersten Tag ein zugelassenes Medizinprodukt zu brauchen? In drei Phasen. Phase eins ist ein reiner Dienstleistungs-Service: Man nimmt die Fälle, die ein simpler, leitlinien-getriebener Vorfilter ohnehin heraussiebt, und lässt einen Experten über genau diese Vorauswahl schauen. Er sagt bei jedem: Moyamoya, ja oder nein. Das kostet nur Facharzt-Zeit und schafft etwas Wertvolles.
Nämlich eine saubere, von Experten gelabelte Datenbasis — kein verrauschtes Schlüsselwort mehr, sondern echte Urteile. Darauf trainieren wir in Phase zwei den Klassifikator. Jetzt steht er auf festem Grund.
Und in Phase drei dreht sich der Spieß: Der bildgetriebene Klassifikator findet zusätzliche Moyamoya-Fälle, die der simple Vorfilter übersehen hätte, und legt sie dem Arzt vor. So wird aus dem Dienst nach und nach ein Medizinprodukt, das Moyamoya deutlich besser heraussiebt als die ursprüngliche, starre Regel. Der Service finanziert die Daten, die Daten machen das Produkt, das Produkt schlägt die Regel.
47 · Was fehlt: eine realistische Testkohorte
Bleibt eine ehrliche Lücke, die größer ist als dieser eine Fall. Wenn wir behaupten, ein Modell findet Moyamoya unter ganz normalen Patienten, dann müsste man das an genau der Mischung testen, die im Klinikum tatsächlich ankommt: die seltenen Fälle gegen tausende gewöhnliche — vor allem die häufigen Look-alikes wie den akuten Schlaganfall, mit dem Moyamoya oft verwechselt wird. Solche gewöhnlichen Vergleichsfälle in dieser Menge haben wir aber nicht. Die naheliegende Abkürzung — die häufigen Fälle einfach von einem Sprachmodell schreiben zu lassen — trägt nicht: Ein Generator schreibt Lehrbuch-Idealfälle, die sich künstlich sauber trennen lassen, während echte Patienten überlappen. Genau diese Überlappung macht die klinische Aufgabe erst schwer und wertvoll, und sie lässt sich nicht faken. Der Beweis, dass ein Modell Moyamoya wirklich im Alltag findet, braucht deshalb eine realistische, prospektiv erhobene Kohorte, die den tatsächlichen Klinik-Alltag widerspiegelt — synthetische Daten taugen zum Prüfen der eigenen Pipeline, nicht als Nachweis.
48 · Vom Signal zum sicheren Medizinprodukt
Jetzt der Weg von diesem Signal zu etwas, dem man wirklich Patienten anvertrauen darf. Alles bisher beruhte auf öffentlichen, unordentlichen Daten — für ein echtes Medizinprodukt braucht es mehr.
49 · Und bis zum echten Medizinprodukt?
Ein letzter, ehrlicher Punkt, der über dieser ganzen Fallstudie steht. Die öffentlichen Daten, mit denen wir hier gearbeitet haben, sind relativ unsauber — und wie wir gesehen haben, stecken noch etliche versteckte Confounds darin, die wir nie vollständig herausfiltern konnten.
Für ein echtes Medizinprodukt reicht das nicht. Man müsste zuerst eine saubere, prospektiv erhobene Datenbasis schaffen — und das Modell dann im klinischen Alltag in einer Studie testen. Erst so kann man sich einigermaßen sicher sein, mit der KI keinen Schaden anzurichten.
Und genau dafür gibt es die Zulassungswege, die europäische M D R und die amerikanische F D A: Sie verlangen den Nachweis von Nutzen und Sicherheit, bevor so ein System auf echte Patienten losgelassen wird. Unsere Zahlen hier sind Hypothesen und ein Machbarkeits-Signal — der Anfang dieses Wegs, nicht sein Ende.
50 · Was so ein System bringen könnte — in Zahlen
Fassen wir den Nutzen so zusammen, wie ihn ein Entscheider sieht — am einen Beispiel, das wir durchgerechnet haben. Ein stiller Bild-Filter könnte die Erkennung von Moyamoya von rund zwei Dritteln auf fast neun Zehntel heben, ohne einen einzigen zusätzlichen Scan — im japanischen Versorgungsnetz grob achtunddreißig zusätzlich früh erkannte Fälle pro Jahr. Der Aufwand bleibt überschaubar: pro Alarm ein zusätzlicher Facharzt-Blick, rund dreizehn Prüfungen je echtem Fund. Und jeder früh erkannte Fall ist über die Lebenszeit grob vierzigtausend Euro wert, vor allem durch vermiedene Behinderung bei jungen Menschen. Alles eine explorative Hochrechnung, kein Zulassungsnachweis — aber die Größenordnung zeigt, warum sich der Aufwand lohnen könnte.
51 · Was das alles bedeutet
Treten wir einen Schritt zurück. Am Anfang stand ein Mensch, der jahrelang nicht weiß, was er hat — für Millionen mit einer seltenen Krankheit ist das Alltag. Die große Hoffnung heißt künstliche Intelligenz. Was wir gesehen haben, ist nüchterner und zugleich ermutigender als der Hype. Es gibt nicht die eine richtige K I. Welche hilft, hängt an der Datenlage. Wo eine behandelbare Krankheit oft genug wiederkehrt, dass ein paar Beispiele existieren, schlägt ein kleines, billiges Modell sogar das große Sprachmodell. Wo es nur den weltweiten Einzelfall gibt, braucht es Wissen und Sprache — und vieles bleibt offen. Entscheidend war die Disziplin: Jede schöne Zahl haben wir gegen Leckage, gegen die Grundrate und gegen die Datenherkunft geprüft — und manche ist dabei zerbrochen. Was übrig bleibt, ist kein Wundermittel, sondern etwas Konkretes: ein stiller Zweitleser, der auf den ohnehin erzeugten Bildern und Berichten mitläuft, die richtigen Fälle erkennt und sie an einen Experten weiterreicht — parallel zur normalen Behandlung, ohne jemanden zu ersetzen. Für den Patienten kann das heißen: Jahre früher eine Antwort, und eine Operation, die einen Schlaganfall verhindert. Genau dafür lohnt sich die Mühe — und die Ehrlichkeit, die dazugehört.
52 · Mehr dazu im Artikel
Die ganze Methodik, alle Zahlen und die geprüften Quellen finden Sie im Artikel direkt unter diesem Video. Danke fürs Zuschauen, und bis zum nächsten Mal.
Was AUROC tatsächlich sagt
Man kann AUROC als Paarvergleich lesen. Ziehen wir zufällig einen positiven und einen negativen Fall: Wie oft gibt das Modell dem positiven Fall den höheren Score? Eine AUROC von 0,5 entspricht zufälliger Reihenfolge. Eine AUROC von 1,0 bedeutet perfekte Sortierung. Eine AUROC von 0,835 heißt vereinfacht, dass der positive Fall in etwa 83,5 % solcher Paare höher liegt.
AUROC sagt weder, ob ein Score von 0,8 wirklich 80 % Risiko bedeutet, noch wie viele Alarme im klinischen Alltag falsch wären. Dafür braucht man Kalibrierung, einen konkreten Schwellenwert und die Häufigkeit der Krankheit in der Zielpopulation.
Bei einer Diagnose-Shortlist ist außerdem Top-k oft näher an der Nutzung. Top-1 fragt, ob die richtige Diagnose ganz oben steht. Top-10 fragt, ob sie unter den ersten zehn Vorschlägen vorkommt. Ein Modell kann also als Suchhilfe brauchbar sein, obwohl seine erste Antwort häufig falsch ist.
HPO-Codes zeigen, wie weit eine einfache Repräsentation trägt
Der erste Versuch beginnt bewusst mit bereits strukturierten Befunden. Dadurch lässt sich prüfen, ob aufwendige Encoder überhaupt einen Zusatznutzen liefern oder ob eine transparente gewichtete Merkmalsliste genügt.
HPO TF-IDF top-1 0,796 · Multi-Hot AUROC 0,991 · TF-IDF AUROC 0,988Vertiefung: Multi-Hot, TF-IDF und warum ein Encoder hier nicht automatisch besser ist
Bei Multi-Hot erhält jeder HPO-Begriff eine Spalte. Ist ein Befund vorhanden, steht dort eine Eins, sonst eine Null. TF-IDF beginnt fast genauso, gewichtet aber häufige, wenig unterscheidende Begriffe schwächer und seltenere Begriffe stärker. Für HPO ist das im Kern eine normalisierte und gewichtete Multi-Hot-Darstellung.
Jeder vorhandene HPO-Term schiebt den Score bestimmter Diagnosen nach oben oder unten. Das Modell bleibt dadurch direkt inspizierbar.
Die Pipeline-Ablation bestätigt, dass nicht bloß die Zahl der Codes den Unterschied erzeugt. Ein reines Count-Modell erreicht AUROC 0,716. Multi-Hot kommt auf 0,991, TF-IDF auf 0,988 und selbst eine auf gleiche Kardinalität beschränkte Multi-Hot-Version auf 0,968. Entscheidend ist also, welche Befunde vorliegen, nicht nur wie viele.
Ein Sprachencoder muss für solche diskreten Codes bei jeder Inferenz ebenfalls rechnen und bringt zusätzliche Annahmen über Sprache mit. Deshalb ist HPO hier kein Argument für komplexere Encoder, sondern ein Kontrollfall: Wenn die Merkmale bereits sauber definiert sind, kann ein lineares Modell die angemessene Lösung sein.
Text und Bild beantworten unterschiedliche Teile derselben Diagnosefrage
MMRareBench enthält zu denselben Fällen klinische Erzählungen und publizierte Bildtafeln. Erst diese Paarung erlaubt einen fairen Modalitätsvergleich, weil Text, Bild und Fusion denselben Patienten und dieselbe Kandidatenliste sehen.
Top-1: Text 0,309 · Bild 0,211 · einfache Fusion 0,343 · Konfidenzintervalle überlappenVertiefung: Was Text, Bild und ihre Kombination mathematisch bedeuten
Für Text erzeugt ein Encoder einen Vektor, dessen Koordinaten wiederkehrende sprachliche und semantische Muster zusammenfassen. Für jedes Bild entsteht ein eigener Bildvektor. Liegen mehrere Abbildungen vor, werden ihre Vektoren zu einer Fallrepräsentation gemittelt. Das lineare Modell berechnet daraus für jede Kandidatendiagnose einen Score.
Text plus Bild bedeutet in diesem Versuch keine geheimnisvolle multimodale Intelligenz. Die kalibrierten Scores beider Modelle werden kombiniert. Wenn der Text eine Diagnose breit unterstützt und das Bild dieselbe Diagnose zusätzlich anhebt, steigt sie in der gemeinsamen Rangliste. Widersprechen sich beide Modalitäten, entscheidet die gelernte Gewichtung.
Text ist im Mittel stärker, weil die Erzählung viele Organsysteme und den Verlauf abdeckt. Bilder helfen selektiv bei Erkrankungen mit sichtbarer Morphologie. Die Fusion steigt numerisch auf 0,343, aber die Unsicherheitsintervalle überlappen. Das Ergebnis lautet daher nicht „Fusion gewinnt“, sondern: Bilder können eine textbasierte Shortlist in einzelnen Fällen sinnvoll umordnen.
Diese Werte dürfen nicht direkt gegen die HPO-Zahlen gestellt werden. HPO und MMRareBench sind verschiedene Kohorten mit anderen Zielmengen und anderer Fallauswahl. Ein fairer Dreiervergleich bräuchte dieselben Patienten mit HPO, prädiagnostischer Prosa und Bildern.
Ein Modell kann die Herkunft der Daten lernen und dabei medizinisch plausibel wirken
Synthetische Fälle und LLM-Umschreibungen lösen Datenknappheit nur scheinbar. Wenn reale und erzeugte Beispiele unterschiedlich formuliert oder codiert sind, entsteht eine Abkürzung: Das Modell erkennt den Herstellungsprozess statt der Krankheit.
Vertiefung: Wort-Bias, lineare Separatoren und warum gleiche Inhalte noch keine gleiche Verteilung bedeuten
Der entscheidende Test hält den medizinischen Inhalt möglichst konstant. Zu 474 Originalfällen wurden je drei Umschreibungen erzeugt. Trotzdem unterscheiden Wort-TF-IDF, Zeichenmuster, Embeddings und sogar reine Formmerkmale Original und Rewrite nahezu perfekt. Der Separator nutzt typische Wortwahl, Satzbau, Abschnittslänge und Formatierung.
Jedes Wort- oder Formmerkmal ist eine Koordinate. Viele kleine Gewichte addieren sich. Sobald die Summe die Grenze überschreitet, ordnet das Modell den Text einer Herkunft zu.
„Inhalt erhalten“ reicht ebenfalls nicht. Im geprüften Teil blieben etwa 88 % der klinischen Entitäten erhalten, zugleich kamen bei rund 20 % zusätzliche Entitäten hinzu. Zahlen und zeitliche Angaben überlebten deutlich seltener. Entsprechend wechselte bei Qwen-Embeddings in 36 % der Fälle die Top-1-Diagnose, obwohl Top-10 ungefähr stabil blieb.
Dasselbe Muster erscheint nach LLM-Generierung und HPO-Mapping: Originale und verarbeitete HPO-Fälle sind mit AUROC 0,993 trennbar. Deshalb darf ein synthetischer Datensatz nicht einfach als zusätzliche klinische Population behandelt werden. Er eignet sich als Belastungstest, solange Herkunft und Zielsignal getrennt ausgewertet werden.
Zwei weitere Tests ordnen dieses Signal ein. Es generalisiert: Ein auf Umschreibungen eines Sprachmodells trainierter Separator erkennt die Umschreibungen eines anderen Modells mit fast gleicher AUROC, und das schreibende Modell selbst ist in etwa 91 % der Fälle am Text erkennbar (Zufall 50 %) — eine allgemeine Eigenschaft maschinell geschriebener Prosa, nicht die Handschrift eines einzelnen Werkzeugs. Und für die Diagnose ist es weitgehend kosmetisch: Werden Wortwahl, Textlänge und Befundanzahl angeglichen — als Separator jeweils nahe Zufall —, trennt sich ein seltener Fall allein über den klinischen Inhalt von einem häufigen. Die Produktionssignatur ist hoch detektierbar, verschiebt die medizinische Rangfolge für sich genommen aber kaum.
In-depth: Warum Moyamoya ein guter Prüfstein ist
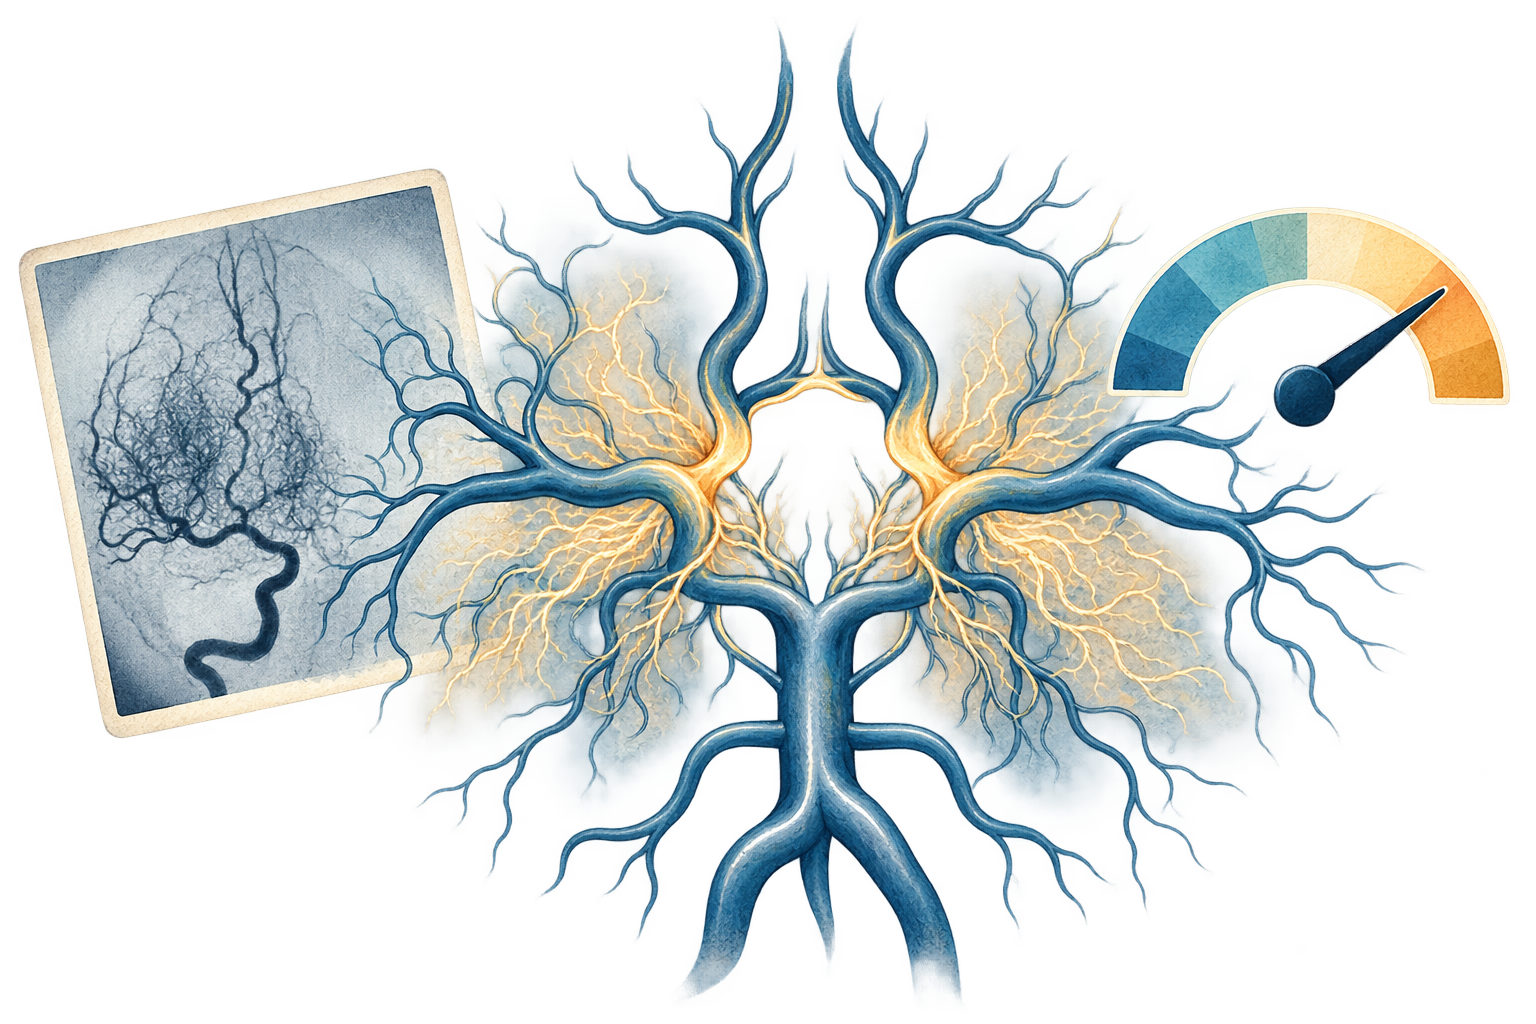
Die allgemeinen Experimente zeigen, wo Rare-Disease AI scheitern kann. Moyamoya macht daraus eine konkrete klinische Kette. Die Erkrankung verengt typischerweise die terminalen intrakraniellen Karotiden. Als Reaktion entstehen feine Kollateralgefäße, deren angiografisches Erscheinungsbild an eine Rauchwolke erinnert. Patientinnen und Patienten können mit TIA, ischämischem Schlaganfall, Kopfschmerzen oder intrakranieller Blutung auffallen.
Im Stroke-Work-up ist die interessante Frage nicht, ob ein Modell eine Lehrbuchabbildung erkennt. Es müsste Moyamoya von plausiblen vaskulären Alternativen unterscheiden und dabei eine bereits entstandene CTA- oder MRA-Aufnahme für eine zweite fachärztliche Prüfung markieren. Genau diese engere Aufgabe bestimmt Kohorte, Negative und Metriken.
Der sinnvolle Gegner ist ein vaskulärer Mimic, kein beliebiges Normalbild
Eine leichte Benchmark würde Moyamoya-Angiografien gegen Fotos oder unauffällige Aufnahmen stellen. Der relevante Test verwendet stattdessen Vaskulitis, Atherosklerose, Dissektion, RCVS und andere neurovaskuläre Differenzialdiagnosen.
Vertiefung: Kohorte, Modalität und vorgesehener Einsatzpunkt
Die Daten stammen aus publizierten Fallberichten. Das schafft Zugang zu seltenen Positiven, bringt aber Publikationsselektion, unterschiedliche Modalitäten und nachträglich ausgewählte Abbildungen mit. Die Labels beruhen noch auf einer Keyword-basierten Kandidatensuche und benötigen ärztliche Adjudikation.
Alle Fälle und Bilder desselben Artikels bleiben im selben Split. Ohne diese Gruppierung könnte das Modell Layout, Scanner-Overlay oder Bildaufbereitung eines Artikels wiedererkennen. Das sähe wie medizinische Generalisierung aus, wäre aber eine Form von Wiedererkennung.
Der realistische Zielpunkt wäre CTA oder MRA bei jungen, kryptogenen oder atypischen Schlaganfällen. Natives CT zeigt die charakteristischen Stenosen und Kollateralen nicht zuverlässig. Für einen NCCT-Fallfinder fehlen derzeit öffentliche Moyamoya-positive Akutdatensätze mit angiografischer Referenz.
Sortierung, Wahrscheinlichkeit und Bildsignal brauchen getrennte Prüfungen
Die verschachtelte Auswertung prüft zuerst, ob die komplette Modellwahl neue Artikel sortieren kann. Danach wird die Wahrscheinlichkeit kalibriert. Ausschnitte und klinische Variablen untersuchen anschließend, worauf das Signal beruhen könnte.
Vertiefung: Nested CV, Kalibrierung, Gefäß-ROI und klinische Konfundierung
Nested Cross-Validation trennt Modellwahl und Bewertung. In jeder äußeren Runde wird ein Artikel zurückgehalten. Alle Entscheidungen über Encoder und Kalibrierung entstehen nur aus den übrigen Artikeln. Erst danach wird auf dem zurückgehaltenen Artikel gemessen. So wird das gesamte Auswahlverfahren bewertet, nicht die beste nachträglich ausgewählte Variante.
Die AUROC von 0,835 bedeutet hier: Ein zufällig gezogener Moyamoya-Kandidat erhält in ungefähr 83,5 % der Paarungen einen höheren Score als ein zufällig gezogener vaskulärer Mimic. Sie sagt noch nicht, dass ein Score von 0,8 eine 80-prozentige Wahrscheinlichkeit darstellt.
Kalibrierung lässt sich mit Wettervorhersagen vergleichen: Wenn an hundert Tagen jeweils 20 % Regen vorhergesagt werden, sollte es ungefähr an zwanzig Tagen regnen. Das rohe Bildmodell sortiert brauchbar, überschätzt seine Sicherheit aber. Eine nur im Training gelernte Platt-Kalibrierung verbessert den Log-Loss Skill Score im gesperrten Test auf +0,206.
+0,206 bedeutet rund 20,6 % weniger probabilistischen Fehler als die triviale Vorhersage, jedem Fall dieselbe Trainingsprävalenz zu geben.
Die Ortsprüfung passt zur Anatomie. Vollbild-AUROC liegt bei 0,850. Center-Crop fällt auf 0,815, Tiles auf 0,719. Ein Gefäß-ROI erreicht 0,861. Alter und Geschlecht allein erreichen 0,824, weil die Fallauswahl demografisch nicht neutral ist. Bild plus klinische Variablen steigt auf 0,876. Das ist ein Hinweis auf ergänzende Bildinformation, noch kein Beweis unabhängiger Generalisierung.
Der scheinbar beste Textwert von 0,954 wird bewusst ausgeschlossen. Wörter wie „moyamoya“, Bypass-Begriffe, SPECT, Acetazolamid und spezifische Gefäßbeschreibungen stammen aus der bereits erfolgten Diagnostik. Ein klinisch fairer Textversuch benötigt prädiagnostische Beschwerden und Befunde.
Epidemiologie entscheidet, wie oft ein brauchbares Signal helfen kann
Ein identisches Modell erzeugt in verschiedenen Populationen einen anderen positiven Vorhersagewert und erreicht eine andere Zahl von Patientinnen und Patienten. Japan und Europa machen diesen Zusammenhang sichtbar.
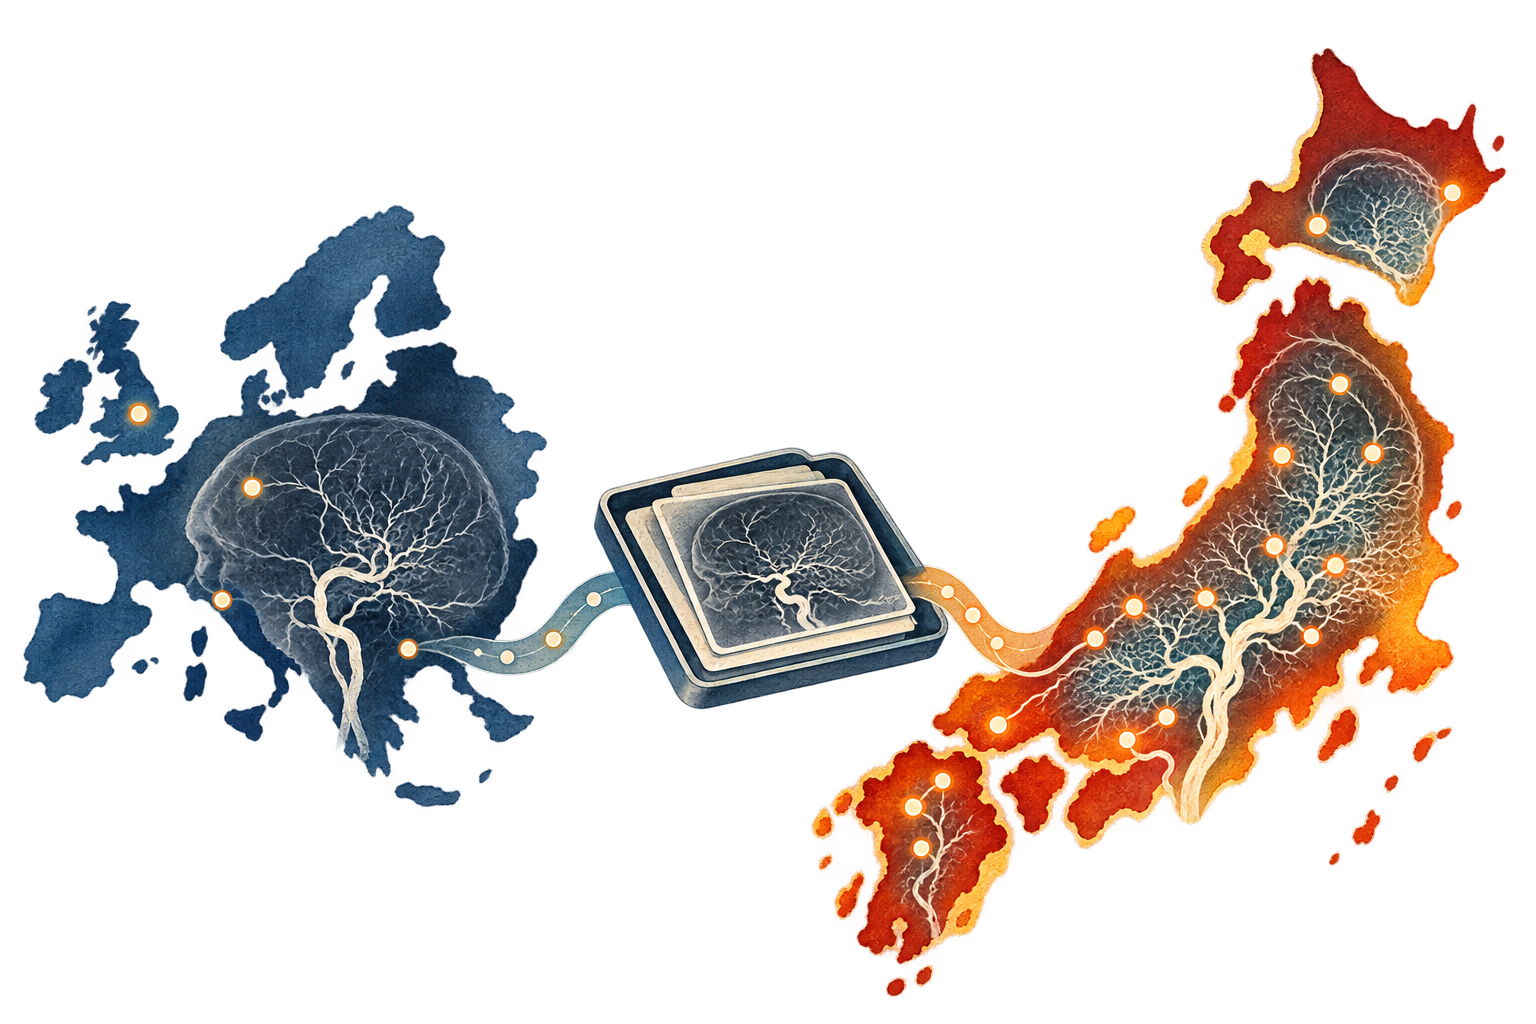
Vertiefung: Basisrate, Review-Last, Behandlungspfad und fehlende Validierung
In einem Netzwerk mit 7,6 Millionen Menschen entsprechen 0,07 Neuerkrankungen pro 100.000 ungefähr 5,3 neuen Fällen pro Jahr. Bei der japanischen Rate wären es etwa 137 bis 182. Für Greater Tokyo mit rund 37,4 Millionen Menschen ergibt dieselbe Rechnung ungefähr 670 bis 900 neue Fälle jährlich. Das beschreibt Krankheitsvolumen, nicht automatisch zusätzliche Modellfunde.
Bevölkerung und Inzidenz sind epidemiologische Anker. Erreichbarkeit, lokale Dunkelziffer und übertragbare Sensitivität müssen im Versorgungssystem gemessen werden.
Die Basisrate verändert auch die Bedeutung eines Alarms. Wie bei einer Sicherheitskontrolle mit einem extrem seltenen Ziel markiert selbst ein recht guter Detektor dann mehr harmlose als echte Fälle. Beim illustrativen Arbeitspunkt mit Sensitivität 0,80 und Spezifität 0,809 läge der positive Vorhersagewert bei 0,2 % Prävalenz nur bei 0,8 %. Das entspricht etwa 120 Prüfungen pro Treffer. Bei 2 % Prävalenz wären es ungefähr 13.
Ein sinnvoller Einsatzpunkt muss die Population anreichern, etwa junge Menschen mit kryptogenem oder atypischem Schlaganfall und vorhandener Gefäßbildgebung. Das Modell wäre dort eine stille Zweitprüfung, kein populationsweites Screening.
Auf einen Verdacht folgen neuroradiologische Bestätigung, hämodynamische Einordnung und individuelle Therapieentscheidung. Im Japan Adult Moyamoya Trial sank bei Erwachsenen mit hämorrhagischer Moyamoya die jährliche Reblutungsrate unter direktem Bypass von 7,6 % auf 2,7 %. Die Evidenz war statistisch knapp und gilt nicht für jede Krankheitsform.
Vor einem klinischen Anspruch fehlen ärztlich adjudizierte Labels, streng gematchte CTA- oder MRA-Kontrollen, die Klassifikationsauswertung nach OCR-Maskierung, externe Kalibrierung in einer echten Stroke-Population und ein retrospektiver Re-Read zur lokalen Dunkelziffer.
Epidemiologie: Liu et al., 2024 und Birkeland et al., 2020. Behandlung: Japan Adult Moyamoya Trial.
Was sich aus den Experimenten mitnehmen lässt
Die Moyamoya-Fallstudie führt die vorherigen Ergebnisse zusammen: Ein messbares Bildsignal kann eine gezielte fachärztliche Zweitprüfung unterstützen – sein Nutzen hängt aber von Datenqualität, Grundrate und Versorgungspfad ab.
Rare-Disease AI braucht keine einheitliche Siegerarchitektur. Strukturierte Codes können mit einfachen linearen Modellen sehr stark sein. Freie Texte tragen mehr klinischen Kontext, aber auch besonders viel Herkunft und postdiagnostische Information. Bilder ergänzen sichtbare Morphologie, verlangen jedoch strenge Kontrolle von Modalität, Zuschnitt und Publikationsartefakten.
Der rote Faden ist die Prüfung des Signals. Jede gute Zahl braucht eine Antwort auf vier Fragen: Welche Information ging hinein? Gegen welche Fälle wurde getestet? Welche Abkürzung könnte das Modell verwenden? Und wie verändert die Basisrate den späteren Einsatz?
Moyamoya ist dafür kein dekoratives Beispiel, sondern die konkrete Fallstudie, in der diese Fragen zusammenkommen. Das Bildsignal ist interessant. Die Textleistung ist leakage-belastet. Die Kalibrierung ist machbar. Der klinische Wert bleibt eine überprüfbare Hypothese.